تاثیر محدودیت منابع هاست cpu: تشخیص، کاهش و بهینهسازی عملکرد سایت
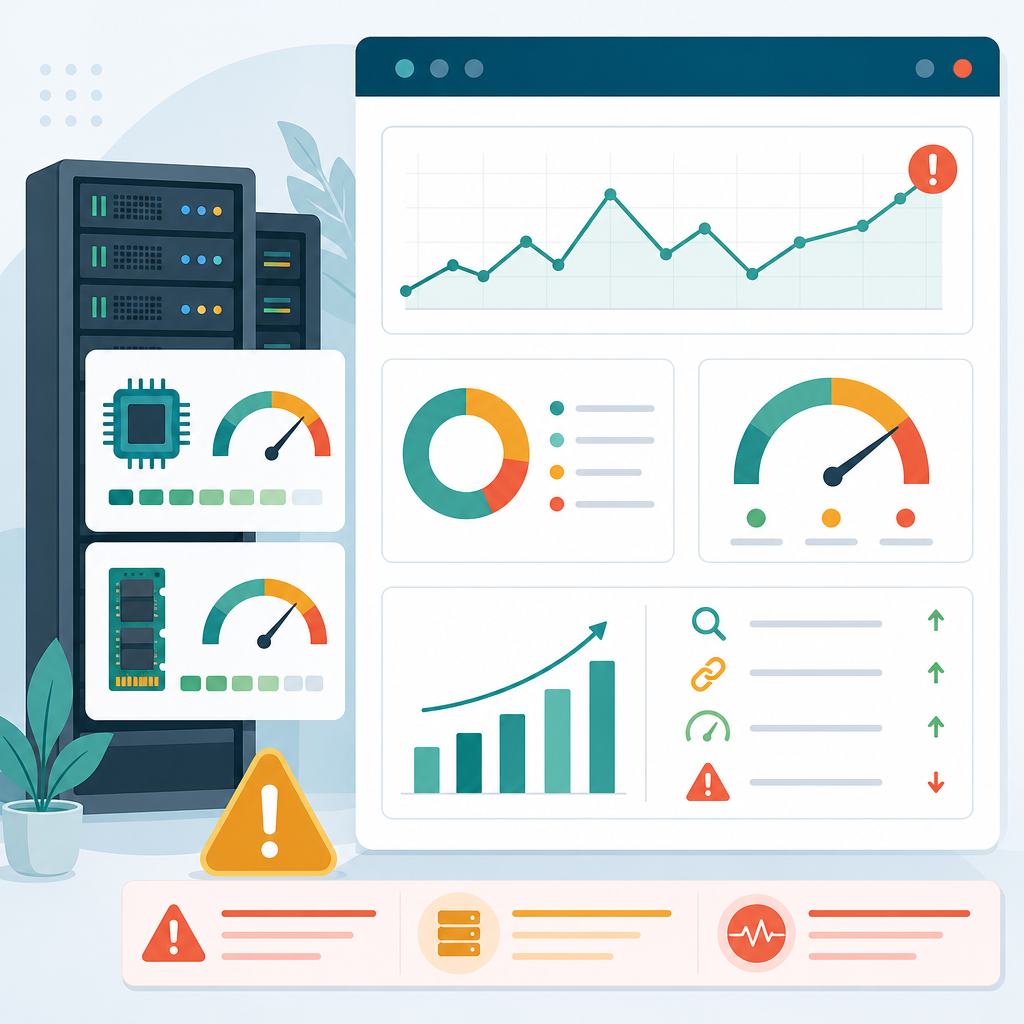
این راهنمای فنی و عملی بهطور متمرکز به تاثیر محدودیت منابع هاست cpu بر عملکرد صفحات وب، تجربه کاربری و شاخصهای سئو میپردازد. هدف ارائه فرایندهای تشخیصی، مثالهای گامبهگام، مراحل اولویتبندی و لیست اقدامات کوتاهمدت و بلندمدت است تا تیم فنی بتواند مشکل را سریع، دقیق و پایدار برطرف کند.
چرا منابع پردازشی سرور برای عملکرد سایت حیاتیاند؟
عملکرد وبسایت به ترکیب چندین مؤلفه بستگی دارد: توان پردازشی (CPU)، حافظه (RAM)، زیرسیستم دیسک (I/O) و شبکه. وقتی تاثیر محدودیت منابع هاست cpu ظاهر شود، معمولاً شاهد افزایش زمان پاسخ اولیه (TTFB)، کاهش توانایی سرویسدهی همزمان و نوسان در تجربه کاربران خواهیم بود. این اثرات در متریکهای ابزارهای تست سرعت و همچنین در رفتار کاربران مانند نرخ پرش و زمان جلسه منعکس میشود.
نشانههای قوی که نشان میدهد مشکل از CPU است
برای تشخیص اینکه آیا CPU عامل اصلی است، به دنبال این نشانهها باشید:
- مصرف پیوستهٔ CPU در بازههای طولانی نزدیک به 90–100٪.
- افزایش قابلتوجه TTFB و کند شدن پردازش صفحات دینامیک در ساعات پیک.
- خطاهای مکرر 5xx یا ریستارت سرویسهای پردازشی تحت بار.
- تأخیر در اجرای پردازشهای پسزمینه و صفبندی طولانی وظایف.
- نوسانهای همزمان در نمودار worker/threads که نشان از رقابت برای CPU دارد.
توجه داشته باشید که علائمی مانند افزایش swap یا I/O بالا میتواند مشابه مشکل CPU نشان دهد؛ بنابراین بررسی چند-محوره (CPU، RAM، I/O و شبکه) ضروری است.
تاثیر محدودیت منابع هاست cpu
در این بخش تأثیرات فنی محدودیت CPU را روی اجزای کلیدی وبسایت مرور میکنیم:
- افزایش زمان پاسخ درخواستهای دینامیک: پردازش توابع سرویسدهنده طولانی شده و هر درخواست منابع بیشتری مصرف میکند.
- کاهش همزمانی سرویسدهی: ظرفیت پردازش همزمان کاهش یافته و صفبندی درخواستها باعث افزایش latency میشود.
- خطا و افت دسترسپذیری: پروسسهای بحرانی ممکن است بهخاطر کمبود منابع کشته یا ریستارت شوند و خطاهای سرویس ظاهر گردد.
- اثر بر ایندکس شدن و SEO: کاهش سرعت و ناپایداری میتواند منجر به کاهش نرخ ایندکس صفحات و افت رتبه در نتایج جستجو شود.
- آسیب به تجربه کاربر موبایل: دستگاههای موبایل به تأخیر و بارگذاری طولانی حساساند و این موضوع روی معیارهای رفتاری و تبدیل تأثیر منفی میگذارد.
تشخیص دقیق: CPU یا عامل دیگر؟
برای تعیین منبع مشکل از این روند گامبهگام استفاده کنید:
- همزمان نمودارهای CPU usage، load average، memory usage، swap activity و disk I/O را در بازهٔ زمانی مشکلزا مشاهده کنید.
- لاگهای سیستم و اپلیکیشن را برای ارورها، OOM و پیامهای مرتبط با resource-exhausted تحلیل کنید.
- از ابزارهای پروفایلینگ و APM برای شناسایی توابع یا کوئریهای پرمصرف بهره ببرید؛ ببینید کدام مسیرهای درخواست بیشترین CPU را مصرف میکنند.
- تست بار کنترلشده در محیط staging اجرا کنید و رفتار سیستم را با محیط تولید مقایسه کنید.
- تست شبکه (latency، packet loss) و I/O (IOPS، latency دیسک) را انجام دهید تا علل غیرپردازشی را رد کنید.
اگر مصرف CPU بالاست و همزمان latency شبکه و I/O نرمال است، احتمالاً تاثیر محدودیت منابع هاست cpu عامل اصلی است؛ در غیر این صورت، مسیرهای دیگر را اولویتبندی کنید.
جدول تشخیصی سریع: نشانه، علت و اقدام
| نشانه | علت محتمل | اقدام اولیه |
|---|---|---|
| TTFB بالا | توابع CPU-محور یا کوئریهای سنگین | پروفایلینگ توابع، فعالسازی کش، بهینهسازی کوئری |
| خطاهای 5xx در پیک | اشباع همزمانی یا محدودیت پردازنده | Rate limiting، صفبندی، افزایش منابع موقت |
| نوسان عملکرد | نشتی حافظه یا I/O شدید | تحلیل مصرف RAM، رفع نشت، بررسی دیسک |
راهکارهای فنی و عملی برای کاهش اثر
برای مدیریت و کاهش تاثیر محدودیت منابع هاست cpu ترکیبی از اقدامات کوتاهمدت و بلندمدت را توصیه میکنیم:
راهکارهای کوتاهمدت (قابل پیادهسازی سریع)
- فعالسازی لایههای کش: کش سطح HTTP، cache نتایج کوئریها و cache صفحات استاتیک تا پردازشهای تکراری حذف شوند.
- محدودسازی نرخ و همزمانی: با rate limiting و connection throttling همزمانی پرسشها را کنترل کنید.
- انتقال پردازشهای سنگین به پسزمینه: استفاده از صفبندی برای کارهای پردازشی طولانی تا سریعترین پاسخ به کاربر برگردد.
- تنظیم وبسرور و workers: تعداد workerها و تنظیمات timeouts را متناسب با منابع CPU تنظیم کنید تا رقابت داخلی کاهش یابد.
راهکارهای میانمدت و بلندمدت
- بهینهسازی کد و کوئری: پروفایلینگ منظم و بازنویسی نقاط داغ پردازشی.
- معماری مقیاسپذیر: جداسازی سرویسها، استفاده از queue و workerهای مستقل برای پردازشهای سنگین.
- افزایش منابع هدفمند: ارتقاء پلان میزبانی یا افزودن پردازندههای مجازی در صورت شواهد مصرف مداوم بالا.
- استفاده از CDN و edge cache: تحویل محتوای ایستا از لبه شبکه برای کاهش بار روی سرور اصلی.
- پایش و آلارمدهی هوشمند: تعریف هشدارهای چندمتریک (CPU، TTFB، error rate) برای اقدام پیشگیرانه.
مثال عملی گامبهگام
سناریویی عملی برای کاهش اثرات اشباع CPU:
- مرحلهٔ جمعآوری: مانیتورینگ 72 ساعته نشان داد CPU در ساعات اوج به بالای 90٪ میرسد و TTFB افزایش مییابد.
- مرحلهٔ تشخیص: پروفایلینگ APM بخش خاصی از کد را نشان داد که در هر درخواست محاسبات سنگینی انجام میدهد؛ کوئریهای بدون ایندکس و حلقههای محاسباتی کشف شد.
- عملیات سریع: نتایج قابلکش کش شد، برخی پردازشها به صف منتقل گردید و محدودیت نرخ برای API اعمال شد.
- آزمون دوباره: اجرای تست بار پس از تغییر نشان داد مصرف CPU 35–45٪ کاهش و TTFB بهبود یافت.
- طراحی بلندمدت: بازنویسی بخش اصلی پردازشی، افزودن workerهای مستقل و پیادهسازی معماری مقیاسپذیر انجام شد تا مشکل تکرار نشود.
این ترکیب از اقدامات موقتی و تغییرات ساختاری نشان میدهد چگونه میتوان تاثیر محدودیت منابع هاست cpu را کاهش داد و از بازگشت مشکل جلوگیری کرد.
پیکربندی پیشنهادی برای مانیتورینگ و آلارم
نمونه آستانهها و متریکهایی که باید پایش شوند:
- CPU usage (avg و per-core): آستانهٔ هشدار اولیه 75٪ و هشدار بحرانی 90٪.
- Load average: مقایسه نسبت به تعداد هستهها (مثلاً load > cores * 1.5 هشداردهنده است).
- TTFB و error rate (5xx): افزایش ناگهانی error rate همراه با TTFB بالا نشاندهندهٔ مشکل جدی است.
- Queue length و worker backlog: رشد صفها معیار مستقیم اشباع پردازش را نشان میدهد.
بهتر است آلارمها ترکیبی از چند متریک باشند؛ مثلاً همزمانی CPU>80٪ و TTFB>1s برای بیش از 5 دقیقه میتواند trigger اقدام خودکار یا escalation باشد.
چکلیست فوری برای مدیران فنی
- بررسی نمودارها: CPU usage، load avg، memory، swap و disk I/O.
- فیلتر لاگها: جستجوی پیامهای resource-exhausted، OOM و خطاهای مرتبط.
- پروفایلینگ: شناسایی توابع و کوئریهای CPUمحور و اولویتبندی اصلاح.
- فعالسازی کش و CDN برای کاهش بار روی سرور اصلی.
- انتقال پردازشهای غیرضروری به پسزمینه و استفاده از صفها.
- پس از هر تغییر، اجرای تست بار و مقایسه متریکها با شرایط پایه.
منابع معتبر برای مطالعهٔ بیشتر
برای توضیحات فنی دربارهٔ بار سیستم و متریکهای مرتبط به مرجع عمومی زیر مراجعه کنید:
پرسشهای متداول (FAQ)
چگونه مطمئن شوم مشکل واقعاً از CPU است؟
همزمان نمودارهای CPU، load avg، latency شبکه و I/O را بررسی کنید. اگر CPU بالا و latency شبکه/IO نرمال باشد و پروفایلینگ توابع پرمصرف را نشان دهد، احتمال بالا بودن سهم CPU وجود دارد.
آیا افزایش RAM یا SSD میتواند مشکل CPU را حل کند؟
افزایش RAM یا SSD میتواند مشکلات مرتبط با swap یا I/O را حل کند اما در مواجهه با محاسبات سنگین پردازشی، RAM/SSD بهتنهایی راهحل نیست. در آن حالت باید به بهینهسازی کد یا افزودن توان پردازشی فکر کنید.
آیا CDN میتواند بهصورت کامل مشکل را رفع کند؟
CDN برای محتوای ایستا بسیار مؤثر است و بار را کاهش میدهد، اما برای صفحات کاملاً دینامیک یا پردازشهای پسزمینه اثربخشی محدودی دارد. ترکیب CDN با caching سمت سرور و بهینهسازی کد بهترین نتیجه را میدهد.