
پشتیبانی مانیتورینگ سرویس ابری: اصول، چکلیست و رویههای عملی
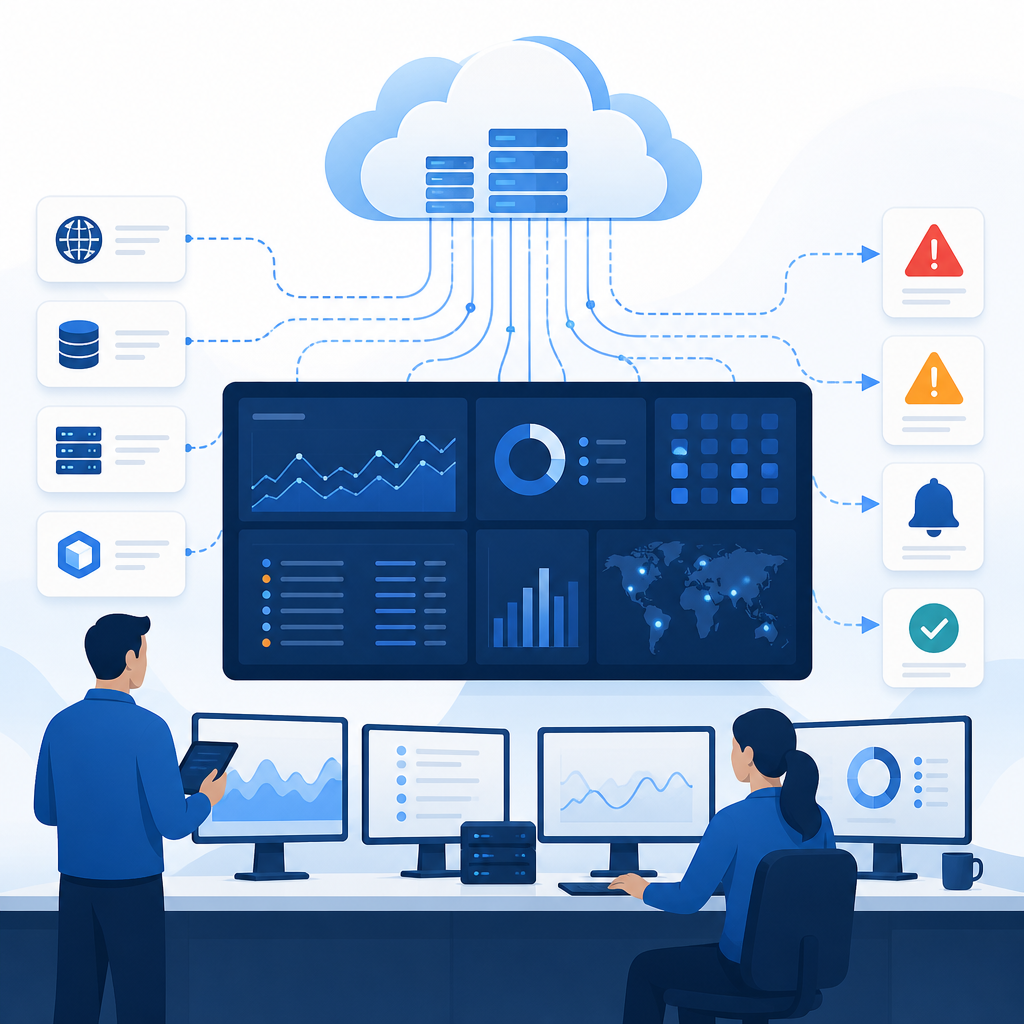
پشتیبانی مانیتورینگ سرویس ابری: اصول، روشها و تجربه کاربردی
پشتیبانی مانیتورینگ سرویس ابری بهمعنای پیادهسازی فرایندها، ابزارها و رویههایی است که تشخیص سریع ناهنجاری، کاهش زمان بازیابی (MTTR) و کمینهسازی هشدارهای کاذب را تضمین کند. این راهنما برای مدیران عملیات، مهندسان پشتیبانی و تیمهای SRE طراحی شده و شامل چکلیستهای عملی، مثالهای سناریویی و الگوهای playbook است.
چرا پشتیبانی مانیتورینگ سرویس ابری اهمیت دارد؟
محیطهای ابری پویا، خودکار و توزیعشده هستند؛ تغییر کانفیگ مکرر، مقیاس افقی و وابستگیهای چندلایه باعث میشود شکستها سریعتر اما ناشناختهتر اتفاق بیفتند. پشتیبانی مانیتورینگ سرویس ابری فرایندی ساختاریافته فراهم میکند تا با جمعآوری Telemetry، تحلیل همزمان و رویههای پاسخ، ناهنجاریها سریع کشف و تاثیر کسبوکار کاهش یابد. علاوه بر کاهش ریسک فنی، این فرایند تجربه کاربری را نیز حفظ میکند.
اجزای کلیدی یک سیستم پشتیبانی مانیتورینگ سرویس ابری
یک پیادهسازی مؤثر باید چند لایه را پوشش دهد و هر لایه قابلیت عملپذیری داشته باشد:
- جمعآوری Telemetry: متریکها، لاگها، تریسها و رویدادها از اپلیکیشن، میکروسرویسها، لایه شبکه و زیرساخت جمعآوری میشود.
- انتقال و ذخیرهسازی: خطوط لوله قابل اعتماد با تضمین ترتیب زمانی، فشردهسازی مناسب و سیاست نگهداری داده.
- پردازش و تحلیل: پردازش جریان برای تشخیص همزمان و پردازش دستهای برای محاسبات شاخصهای تاریخی و مدلسازی پایه.
- هشدارسازی و همبستگی: قوانین مبتنی بر آستانه، مدلهای تشخیص ناهنجاری و همبستگی بین منابع برای کاهش نویز.
- نمایش و گزارشدهی: داشبوردهای عملیاتی، گزارشهای SLA/SLO و گزارشهای پسازرخداد جهت ذینفعان مختلف.
- پاسخ و بازیابی: playbookهای مرحلهای، کارتهای مرجع و رویههای rollback/mitigation تا زمان رفع ریشهای.
شاخصها و اهداف نمونه
نمونهای از KPIها و نحوه اندازهگیری آنها:
| شاخص | هدف | چگونه اندازهگیری شود |
|---|---|---|
| دسترسپذیری | دسترسپذیری 99.9% | درصد زمان بدون وقفه در بازه ماهانه |
| تاخیر | p95 < 300ms | محاسبه صدکها روی تراکنشهای نمونه |
| پایداری | کاهش MTTR به زیر 30 دقیقه | زمان متوسط از هشدار تا بازگشت سرویس |
پشتیبانی مانیتورینگ سرویس ابری
در این بخش طراحی و پیادهسازی پشتیبانی مانیتورینگ سرویس ابری با تاکید بر سه اصل پوشش (coverage)، دقت (accuracy) و قابلیت اقدامپذیری (actionability) توضیح داده میشود. هدف ساختن یک چرخه بازخوردی است که به سرعت وضعیت سرویس را نشان داده و تیم را قادر به اجرا کردن اقدامات موثر کند.
چکلیست طراحی مرحلهای
- فهرست خدمات: تعیین مالک سرویس، نقاط تماس و محدوده مسئولیت برای هر سرویس و تعریف اولیه SLO/SLA.
- شناسایی متریکهای پایه: برای هر لایه (زیرساخت، شبکه، اپلیکیشن، تجربه کاربر) حداقل سه متریک کلیدی انتخاب کنید.
- سیاست نگهداری داده: نگهداری کامل متریکهای دقیقهای برای ۳۰ روز، نمونهبرداری هفتگی برای بلندمدت و فشردهسازی برای دورههای تاریخی.
- طراحی خطوط لوله: تضمین ترتیب زمانی، توان پذیری برای burstها و برچسبگذاری استاندارد (labeling) برای قابلیت گروهبندی و فیلتر.
- قوانین همبستگی: تعریف قوانینی که بر اساس چندین منبع (متریک، لاگ، تریس) رخدادها را تایید کنند و آستانههای سطحبندی را تعیین نمایند.
- تعریف playbookها: شامل مراحل تشخیصی سریع، اقدامات موقتی و مالکیت برای حل دائمی.
- برنامه آموزش و تمرین: برنامه ششماهه برای runbook drills و tabletop exercises.
نمونه قواعد همبستگی ساده
هدف این قواعد کاهش هشدارهای کاذب است. یک الگوی نمونه:
IF (error_rate over 1m > 3%) AND (p95_latency over 5m > 800ms) AND (service_instance_count decreased) THEN create incident severity=high
این قاعده از ترکیب سه منبع برای تایید وقوع مشکل استفاده میکند و جلوی هشدار صرف از روی یک متریک را میگیرد.
فرایند پشتیبانی: از کشف تا حل مشکل
یک فرایند ساختارمند باعث تصمیمگیری سریع و هماهنگ میشود. مراحل پیشنهادی زیر را میتوان بهعنوان هسته یک فرایند پشتیبانی اتخاذ کرد:
- کشف و اعتبارسنجی: هشدارها با استفاده از قواعد همبستگی و دادههای مرجعی فیلتر میشوند تا رویداد واقعی جدا شود.
- اولویتبندی: شدت فنی و تاثیر کسبوکار تعیینشده و سطح پاسخ مشخص میگردد (مثلاً Sev1/Sev2).
- عیبیابی سریع: جمعآوری لاگها، تریسها و متریک مرتبط و بررسی تغییرات اخیر در کانفیگ یا دیپلوی.
- اقدام موقت: اعمال mitigation مانند rollback یا scale-out برای کاهش تأثیر فوری.
- رفع ریشهای و یادگیری: تحلیل پسازرخداد، ثبت علت و اصلاح مستندات و playbook.
نمونه playbook عملیاتی (الگو)
1) دریافت هشدار: جمعآوری شناسه لاگ، p95/p99 و وضعیت سلامت نودها 2) تایید با منابع دوم (تریس یا لاگ دیگر) 3) بررسی تغییرات 60 دقیقه گذشته (deploy, config) 4) اجرای دستورات تشخیصی (health check, tail logs, traceroute) 5) اعمال اقدام موقت (مثلاً scale up یا restart) و ثبت زمان 6) اگر حل نشد، ارتقای incident به تیم رویههای بحرانی 7) پس از حل: گزارشی از علت، اقدامات و بهروزرسانی playbook
ابزارها، استانداردها و انتخاب دادهها
در انتخاب ابزارها به موارد فنی و عملیاتی توجه کنید: تاخیر انداختن در جمعآوری داده، توان پردازش موازی، پشتیبانی از تریسینگ توزیعشده و قابلیت تعریف قواعد همبستگی. برای سازگاری طولانیمدت از فرمتها و پروتکلهای باز استفاده کنید؛ مثلاً پروتکلهای استاندارد برای لاگ و تریس اغلب در مستندات رسمی توضیح داده شدهاند (مراجع رسمی استاندارد).
- متریکهای زیرساخت: مصرف CPU، حافظه، I/O و صفها
- متریکهای اپلیکیشن: نرخ موفقیت، نرخ خطا، صدکهای تاخیر
- لاگها: لاگهای ساختاریافته با شناسه تراکنش
- تریسها: دنبالکردن مسیر کامل درخواست در تمام میکروسرویسها
مثال عملی: راهاندازی فرایند برای سرویس با بار متوسط
این سناریو کاربردی کمک میکند تا مباحث پیشین را در عمل ببینید:
- تعریف اهداف: دسترسپذیری 99.9% و p95 زیر 300ms برای تراکنشهای اصلی.
- فعالسازی جمعآوری: ارسال متریکهای پایه و لاگها به مخزن مرکزی با برچسبگذاری مبتنی بر سرویس و محیط.
- ساخت داشبورد: صفحات وضعیت برای تیم عملیات، صفحه خطاها و صفحه تجربه کاربر.
- تنظیم هشدارها: آستانهها بر اساس تاریخچه و با قواعد همبستگی اولیه تعریف میشوند.
- نوشتن playbook: الگوهای common و emergency با مشخصشدن مالک و کانال ارتباطی.
- برنامه تمرین: شبیهسازی سناریوهای انفجار ترافیک و شکست نود برای سنجش MTTR.
در این مثال، پشتیبانی مانیتورینگ سرویس ابری بهوسیله جلسات بازخورد هفتگی بین تیم توسعه و عملیات تقویت میشود تا آستانهها و رویهها تدریجی بهینه شوند.
شاخصهای سنجش عملکرد پشتیبانی و الگوهای گزارش
معیارهای کلیدی و نحوه محاسبه و گزارش آنها:
- میانگین زمان بازیابی (MTTR): مجموع زمانهای بازیابی تقسیم بر تعداد رخدادها.
- نرخ هشدارهای کاذب: نسبت هشدارهایی که به incident منجر نمیشوند به کل هشدارها.
- نسبت حل در اولین تماس (FCR): درصد رخدادهایی که در اولین ورود حل میشوند.
- میانگین زمان اولین پاسخ: زمان متوسط از هشدار تا اولین اقدام انسانی یا خودکار.
گزارشهای هفتگی و ماهانه باید روندها، گلوگاهها و پیشنهادات بهبود را نشان دهند تا تصمیمگیری مدیریتی سادهتر شود.
چالشها و راهکارهای متداول
در عمل با مسائلی مانند حجم بالای داده، هشدارهای کاذب و پراکندگی مالکیت روبهرو خواهید شد. راهکارهای کارآمد:
- استفاده از همبستگی و تایید متقابل منابع برای کاهش نویز.
- تعیین مالکیت واضح برای هر سرویس و هر playbook (RACI matrix).
- نمونهبرداری هوشمند و فیلترینگ لاگ برای کاهش هزینههای ذخیرهسازی.
- اجرای منظم تمرینهای شبیهسازی حادثه و بازنگری پسازرخداد.
ملاحظات امنیتی و حریم خصوصی
دسترسی به دادههای مانیتورینگ باید بر اساس اصل حداقل دسترسی و قابل حسابرسی باشد. نکات عملی:
- رمزنگاری دادهها در انتقال و حالت استراحت.
- حذف یا ماسککردن دادههای حساس در لاگها و تریسها.
- ثبت جداگانه و قابل بررسی دسترسیهای اداری و APIها.
- سیاست نگهداری دادهها و حذف امن بر اساس نیازهای قانونی و فنی.
برنامه تمرینی (Runbook Drills)؛ گام به گام
اجرای تمرین منظم، توان پاسخدهی تیم را تقویت میکند. نمونه برنامه چهار مرحلهای:
- طراحی سناریو: انتخاب سناریویی که بیشترین ریسک را دارد (مثلاً کاهش ناگهانی ظرفیت).
- اجرای تمرین بدون اطلاع تیم عملیاتی (surprise drill) برای ارزیابی واکنش واقعی.
- جمعآوری دادههای عملکردی و زمانبندیها و تحلیل MTTR و FCR.
- بازنگری playbook و بهروزرسانی نقشها و مسئولیتها بر اساس نتایج.
پرسشهای متداول (FAQ)
پشتیبانی مانیتورینگ سرویس ابری چه تفاوتی با مانیتورینگ سنتی دارد؟
در محیط ابری تمرکز بر مقیاسپذیری، خودکارسازی و تعامل مولفهها است. پشتیبانی علاوه بر مانیتورینگ شامل فرایندهای پاسخ، مالکیت و بازیابی است که باید با تغییرات پویا هماهنگ شود.
چگونه میتوان هشدارهای کاذب را کاهش داد؟
با تعریف قواعد همبستگی بین منابع، آستانههای پویا مبتنی بر تاریخچه و تأیید رخداد از چندین منبع. بازبینی دورهای آستانهها و تحلیل پسازرخداد نیز ضروری است.
چه شاخصهایی برای سنجش پشتیبانی مهمتر هستند؟
MTTR، نرخ هشدارهای کاذب، نسبت حل در اولین تماس و زمان اولین پاسخ از جمله شاخصهای کلیدی هستند که روندها و نقاط ضعف را نشان میدهند.
نتیجهگیری
پشتیبانی مانیتورینگ سرویس ابری نیازمند ترکیب ابزار مناسب، چارچوب فرایندی و فرهنگ پاسخگویی است. با تعریف SLOهای واقعبینانه، تعیین آستانههای معقول، اتوماسیون بخشهای تکراری و تمرین مداوم، تیمها میتوانند زمان تشخیص و بازیابی را بهطور قابلتوجهی کاهش دهند، هشدارهای کاذب را کمینه نمایند و پایداری سرویسها را افزایش دهند. پیادهسازی چرخهٔ بررسی مستمر و بهروزرسانی playbookها تضمین میکند که پشتیبانی مانیتورینگ سرویس ابری همواره با تغییرات معماری و نیازهای کسبوکار همگام بماند.