
بهینهسازی پاسخ سرور کاهش خطا: اصول و راهکارهای کاربردی
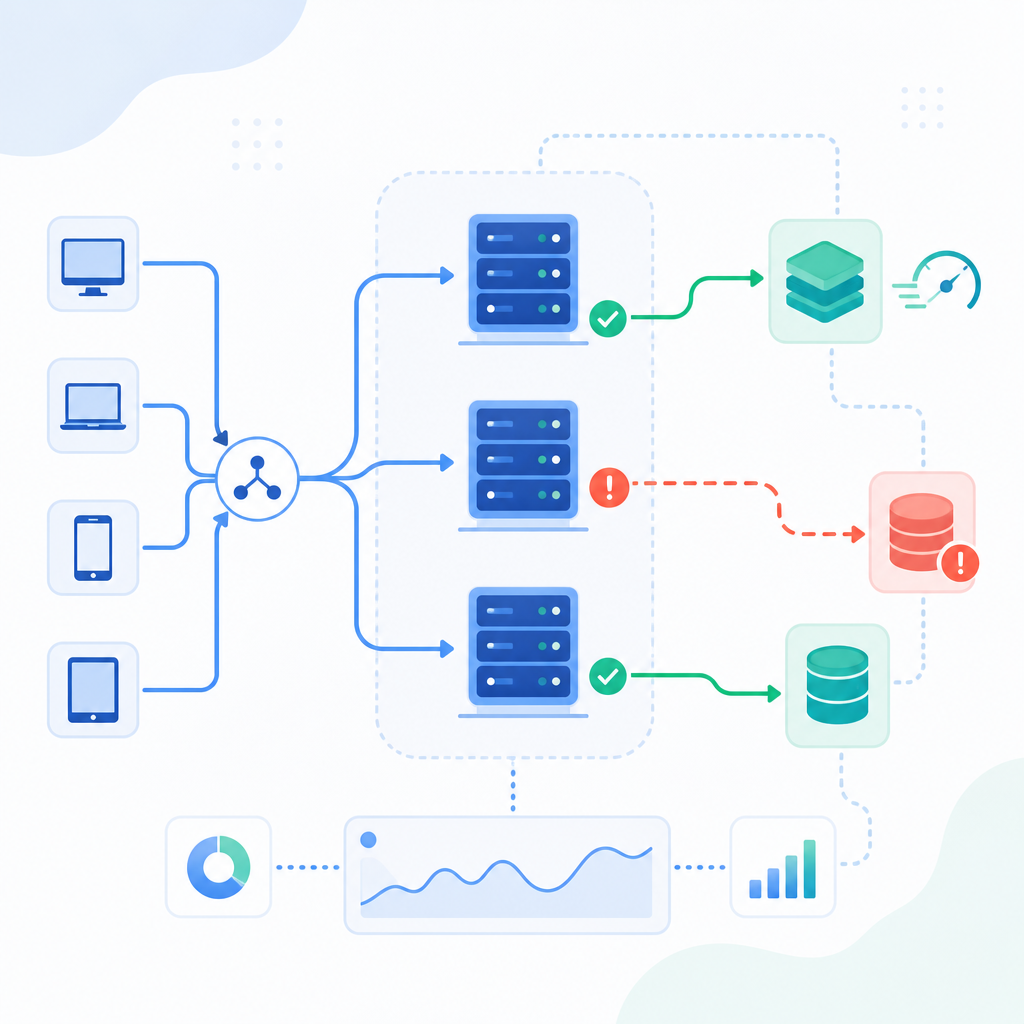
بهینهسازی پاسخ سرور کاهش خطا: اصول و راهکارهای کاربردی
در این راهنمای جامع، بهینهسازی پاسخ سرور کاهش خطا بهصورت عملیاتی شرح داده میشود تا بتوانید نرخ خطا را کاهش دهید، زمان بازیابی را کوتاه کنید و تجربه کاربری را بهبود بخشید. متن برای کاربرد در معماریهای مختلف و بدون وابستگی به محصول یا سرویس خاصی تدوین شده است.
بهینهسازی پاسخ سرور کاهش خطا: چرا اهمیت دارد و چگونه شروع کنیم
وقتی پاسخ سرور بهموقع و معنادار نباشد، پیامدها شامل افت رضایت کاربر، کاهش تبدیل و فشار عملیاتی میشود. بهینهسازی پاسخ سرور کاهش خطا شامل طراحی پیامها، تنظیم تایماوتها، پیادهسازی کنترل بار و ابزارهای پایش است تا هم وقوع خطا کاهش یابد و هم اثر آن در صورت بروز محدود گردد.
اهداف فنی و کسبوکاری
- کاهش نرخ خطاهای قابل مشاهده توسط کاربران و سرویسهای مصرفکننده
- کاهش زمان تا بازگشت به وضعیت پایدار (MTTR)
- اطلاعات ساختاریافته برای واکنش خودکار و تحلیل ریشهای علت
اصول فنی پایه برای کاهش خطا در پاسخ سرور
تمرکز بر چهار لایه اصلی — شبکه، اپلیکیشن، داده و لایههای خارجی — موجب شناسایی و رفع علل ریشهای خطا میشود. در ادامه اصول کلیدی با توضیحات و نمونههای عملی آمده است.
۱. استفاده از کدهای وضعیت HTTP معنادار
کد وضعیت صحیح، رویکرد خودکار و انسانی برای مواجهه با خطا فراهم میکند. نکات عملی:
- از سری 4xx برای خطاهای قابل اصلاح توسط کلاینت و از سری 5xx برای مشکلات سرور استفاده کنید.
- در پاسخهای خطا ساختاری مشخص (مثلاً JSON) با فیلدهایی مثل status، error، message و trace_id قرار دهید تا لاگینگ و correlation آسان شود.
۲. تعیین تایماوتها و مدیریت زمانبندی
تعریف تایماوت مناسب در لایههای مختلف از بلوکه شدن منابع جلوگیری میکند. توصیهها:
- برای هر نوع تراکنش تایماوت جداگانه تعریف کنید: درخواستهای کوتاه، پردازشهای طولانی و کارهای پسزمینه.
- تایماوتها را با SLAها همراستا کرده و در محیط تست با ترافیک واقعی یا شبیهسازیشده آزمون کنید.
۳. پیامهای خطا واضح، ساختاریافته و امن
پیام خطا باید هم برای کاربر مفید و هم برای تیم فنی قابل تحلیل باشد، اما جزییات حساس را فاش نکند. نمونه ساختار پیشنهادی:
{
  "status": 503,
  "error": "service_unavailable",
  "message": "سرویس موقتاً در دسترس نیست. لطفاً بعداً تلاش کنید.",
  "retry_after": 30,
  "trace_id": "abcd-1234"
}
۴. کنترل بار و جلوگیری از فروپاشی
مکانیزمهای نرخمحدودکننده، صفبندی و graceful degradation از سرایت خطا جلوگیری میکنند.
- درخواستهای کماولویت را به صف منتقل و پردازش غیرهمزمان کنید.
- در پاسخ محدودکننده از هدرهایی مانند Retry-After استفاده کنید تا کلاینتها استراتژی backoff بهکار ببرند.
چکلیست اجرایی برای کاهش خطا
فهرست زیر گامهای عملی و کمریسک را برای اجرا در محیطهای تولید نشان میدهد:
| مسئله | اقدام پیشنهادی | نتیجه مورد انتظار |
|---|---|---|
| پاسخهای کند | استفاده از کش لایهای، بهینهسازی کوئریها، حذف محاسبات تکراری | کاهش زمان پاسخ و کاهش خطاهای ناشی از تایماوت |
| نوسان منابع منجر به 5xx | اعمال نرخمحدودکننده، صفبندی، retry با backoff کنترلشده | کنترل بار و افزایش پایداری در اوج ترافیک |
| ورودی نامعتبر | اعتبارسنجی سطحِ ورودی و بازگرداندن 4xx مناسب | حفظ منابع و کاهش خطاهای غیرمنتظره |
نمونهسناریوی عملی: مواجهه با بار ناگهانی
در سناریویی که نرخ درخواست بهسرعت افزایش مییابد و برخی درخواستها 503 یا 504 میشوند، الگوی واکنش زیر را اجرا کنید:
- فوراً نرخمحدودسازی (rate limiting) برای درخواستهای جدید اعمال شود تا بار اولیه کنترل شود.
- درخواستهای خواندن غیرحیاتی از کش سطحی پاسخ داده شوند تا فشار روی دیتابیس کاهش یابد.
- در پاسخهای ردشده مقدار Retry-After اعلام و در کلاینتها backoff نمایی تعیین شود.
- در صورت نیاز، مقیاسافزایی موقت (scale up/out) یا انتقال برخی عملیات به صف انجام پذیرد.
- شاخصهای کلیدی (نرخ خطا، p95/p99 زمان پاسخ، طول صف) پایش شده و براساس آن قواعد بازیابی خودکار اعمال شود.
نمونه هدر راهنمای retry:
HTTP/1.1 503 Service Unavailable
Content-Type: application/json
Retry-After: 30

{ "status": 503, "message": "مشکل موقتی، لطفاً پس از 30 ثانیه تلاش کنید." }
مانیتورینگ، اندازهگیری و شاخصهای کلیدی
اندازهگیری دقیق برای ارزیابی تأثیر اقدامات ضروری است. ترکیبی از شاخصها بهتر از اتکا به یک عدد منفرد است:
- نرخ خطا تفکیکشده بر اساس مسیر و کد وضعیت (4xx/5xx)
- توزیع زمان پاسخ: میانگین، p95 و p99
- عرض صفها و نرخ رشد آنها
- مصرف منابع: CPU، حافظه، I/O و اتصالات فعال به دیتابیس
- وابستگیهای خارجی: نرخ خطا و زمان پاسخ سرویسهای ثالث
برای مرجع پروتکل و رفتار کدهای وضعیت میتوانید به استاندارد HTTP مراجعه کنید: RFC 7231.
الگوهای معماری مؤثر
استفاده از الگوهای معماری مناسب، اثر خطاها را محدود میکند:
- تفکیک سرویسها (microservice یا bounded-context) تا خرابی یک بخش کل سامانه را مختل نکند.
- صفبندی برای پردازش ناهمزمان کارهای سنگین و جلوگیری از مسدودسازی درخواستهای فوری.
- پیادهسازی circuit breaker برای قطع تماس با سرویسهای ناپایدار و جلوگیری از retryهای بیاثر.
- استراتژی bulkhead برای تخصیص منابع به بخشهای مجزا و جلوگیری از سرایت خرابی.
مراحل پیادهسازی گامبهگام
روند پیشنهادی برای اعمال تغییرات با حداقل ریسک:
- شناسایی مسیرهای پرتکرار و بحرانی که بیشترین خطا را تولید میکنند.
- اعمال تغییرات کوچک و قابل برگشت: تنظیم تایماوتها، اصلاح پیامهای خطا، افزودن محدودکننده نرخ برای مسیرهای خاص.
- اجرای تست بار محدود و مقایسه شاخصها پیش و پس از تغییر (Canary یا A/B).
- گسترش تدریجی تغییرات در محیط تولید در صورت مشاهده بهبود.
- مستندسازی و افزودن قواعد به runbook برای رخدادهای مشابه در آینده.
نمونه سادهای از runbook هنگام افزایش نرخ 5xx:
1. بررسی شاخصها: نرخ 5xx، طول صف و مصرف منابع
2. فعالسازی نرخمحدودکننده در مسیرهای آسیبپذیر
3. ارسال هشدار به تیم عملیات و اعمال مقیاسافزایی موقت در صورت نیاز
4. بررسی لاگها و trace_id برای یافتن علت ریشهای
5. بازگرداندن تنظیمات پس از ثبات و مستندسازی اقدامات
مثالهای کاربردی و مقایسه روشها
سه مثال عملی و مقایسهای که به تصمیمگیری کمک میکنند:
مثال اول — سرویس خواندن با بار بالا
راهحل: افزودن کش در لبه (edge cache) و fallback به پاسخ کمجزئیات هنگام بار شدید. نتیجه: کاهش مستقیم در نرخ خطاهای تایماوت و بهبود p99.
مثال دوم — عملیات نوشتن پیچیده
راهحل: وارد کردن صف و پردازش ناهمزمان با اطمینان از idempotency. نتیجه: کاهش ترافیک همزمان روی دیتابیس و کاهش 5xx.
مثال سوم — سرویس وابسته به سرویس خارجی
راهحل: اعمال circuit breaker و cache پاسخهای اخیر بهعنوان fallback. نتیجه: جلوگیری از cascade failure و کاهش نرخ خطاهای کاربرپسند.
پرسشهای متداول (FAQ)
آیا بهینهسازی پاسخ سرور کاهش خطا همیشه هزینهبر است؟
خیر. بسیاری از اقدامات کمهزینه هستند، مانند تنظیم تایماوتها، اصلاح پیامهای خطا و بهینهسازی کوئری. تنها برخی تغییرات زیرساختی یا بازطراحی معماری ممکن است مستلزم هزینه باشند و نیاز به تحلیل هزینه-فایده دارند.
چه زمانی retry در سمت کلاینت مناسب است؟
برای خطاهای موقتی مانند 429 یا 503 و در صورتی که از backoff نمایی و محدودیت تعداد تلاشها استفاده شود مناسب است؛ retry نابجا میتواند بار را افزایش دهد و مشکل را تشدید کند.
چگونه اثر تغییرات را اندازهگیری کنیم؟
از استراتژی Canary یا A/B استفاده کنید و شاخصهایی مانند نرخ خطا، p95/p99 زمان پاسخ و نرخ موفقیت تراکنشها را پیش و پس از تغییر مقایسه کنید.