خطایابی ورکفلو n8n: راهنمای عملی مرحلهبهمرحله
مقدمه
این راهنما مجموعهای ساختاریافته و عملیاتی برای خطایابی ورکفلو n8n ارائه میدهد. هدف، کاهش زمان تشخیص مشکل، افزایش تکرارپذیری در تستها و ارائه راهکارهای قابل پیادهسازی برای رفع خطاهاست. در ادامه مفاهیم پایه، چکلیست عملی، نمونه لاگ و راهکارهای پیشرفته آورده شده است تا بتوانید در کمترین زمان ریشه مشکل را شناسایی و اصلاح کنید.
خطایابی ورکفلو n8n — رویکرد کلی
پیش از ورود به جزئیات، یک الگوی کلی پیشنهاد میشود: ثبت، بازتولید، تفکیک، تحلیل لاگ و اصلاح. این پنج گام را بهعنوان چرخهای تکرارشونده در نظر بگیرید که با هر تکرار، دامنه خطا کوچکتر و اطلاعات بیشتری درباره علت فراهم میآید.
چرا ساختارمند بودن مهم است؟
در گردشکارهای اتوماسیون خطاها ممکن است از منابع متنوعی ناشی شوند—دادههای ورودی، پیکربندی گرهها، محدودیتهای شبکه یا سرویسهای خارجی و مشکلات منابع محلی. بدون رویکرد سازمانیافته، تلاشها پراکنده و زمانبر خواهند شد. رویکرد ساختاریافته به شما کمک میکند:
- سرچشمه خطا سریعتر شناسایی شود،
- تغییرات دقیق و قابل بازگشت اعمال شوند،
- مستندسازی برای انتقال دانش انجام شود،
- راهحلهای پایدار بهجای رفع موقت اجرا شوند.
چکلیست پایهای برای شروع
- ثبت مشکل دقیق: پیام خطا، زمان وقوع، شناسه اجرا (run id)، پارامترهای ورودی و میزان تکرارپذیری را یادداشت کنید.
- محیط بازتولید: یک کپی از ورکفلو در محیط تست یا staging بسازید تا تغییرات را بدون ریسک روی تولید آزمایش کنید.
- بررسی ورودیها: فرمت و نوع داده، فیلدهای اجباری و ورودیهای مرزی را اعتبارسنجی کنید.
- خواندن لاگها: لاگهای اجرا، پیامهای خطا و استکترَیس را استخراج و تحلیل نمایید.
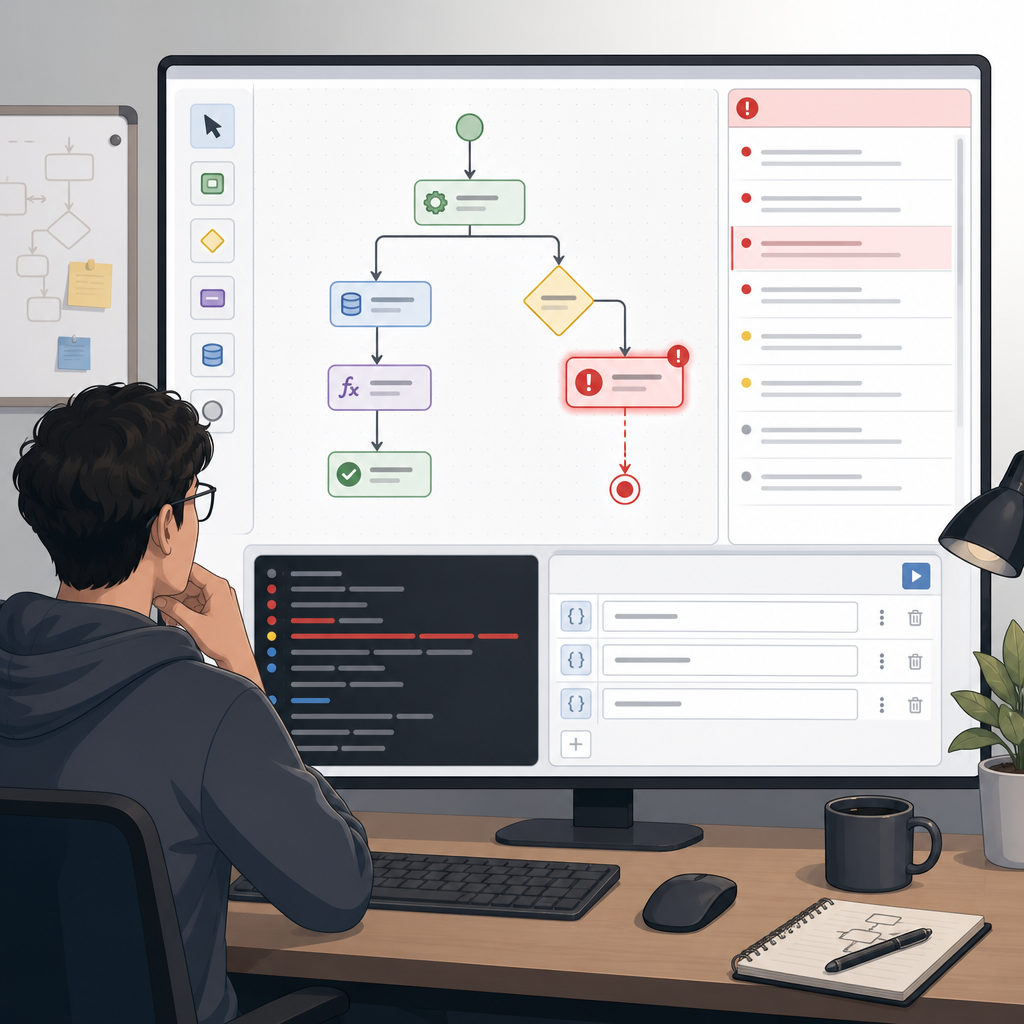
- جداسازی گرهها: گرهها را تکبهتک اجرا کنید تا محل دقیق بروز خطا مشخص شود.
- مستندسازی و بازگشت: تغییرات را ثبت و در صورت مشکل سریعاً rollback کنید.
ابزارها و روشهای مفید
برخی شیوهها و ابزارها روند خطایابی را تسهیل میکنند:
- ذخیره ساختارمند لاگها بهصورت JSON برای جستجو و فیلتر سریع،
- محیطهای ایزوله برای بازتولید بدون اثرگذاری بر تولید،
- نوشتن تستهای واحد برای تبدیلهای دادهای هر گره،
- مانیتورینگ منابع (CPU، حافظه، I/O) برای شناسایی گلوگاهها،
- استفاده از لاگینگ متمرکز و شناسه اجرا (correlation id) برای دنبال کردن جریانهای موازی.
برای استانداردهای HTTP و بررسی کدهای وضعیت و رفتارهای رایج سرورها میتوانید مستندات استاندارد HTTP را ملاحظه کنید: RFC 7231 (HTTP).
راهنمای گامبهگام عملی
در این بخش هر مرحله با جزئیات عملی توضیح داده شده است تا مستقیماً در محیط توسعه یا تست قابل اجرا باشد.
1. ثبت و دستهبندی خطا
اطلاعات زیر را همیشه ثبت کنید: شناسه اجرا، زمان و منطقه زمانی، پیام خطا کامل، گرههای درگیر، مقدار ورودی مهم و تعداد تلاشها. دستهبندی کار شما را در اولویتبندی رفع مشکل یاری میدهد (اتصال، داده، منطق یا منابع).
2. بازتولید مسئله در محیط کنترلشده
قدم به قدم محیط و ورودیهای اجرا را بازسازی کنید. اگر بازتولید امکانپذیر نیست، احتمالاً مشکل وابسته به شرایط محیطی یا دادههای زمان اجرا است. یادداشت کنید کدام پارامترها برای بازتولید لازم بودند.
3. بررسی ورودیها — نمونههای عملی
همیشه موارد مرزی را تست کنید: رشتههای خالی، مقادیر null، اعداد بزرگ، تاریخهای نامعتبر و دادههای نوع نادرست. مثال عملی: اگر گرهای منتظر فیلد عددی است، چهار دسته ورودی امتحان کنید — مقدار صحیح، عدد اعشاری، رشته عددی و مقدار خالی — سپس پاسخ و پیامهای خطا را مقایسه کنید.
4. جداسازی گرهها و اجرای تدریجی
گرهها را یکییکی اجرا کنید و بین هر گره یک گره ثبت لاگ (یا خروجی ساده) قرار دهید تا ساختار و نمونه داده میانگذر ثبت شود. این کار بهسرعت مشخص میکند کدام تبدیل یا تابع باعث تغییر ساختار داده شده است.
5. خواندن دقیق لاگها و پیامهای خطا
لاگها را بهدنبال الگوها و مقادیر مشکوک بررسی کنید: کدهای وضعیت HTTP، مسیر فراخوانی، نمونهای از payload و زمانهای پاسخ. برای لاگینگ پیشنهاد میشود از ساختار JSON استفاده کنید تا فیلترینگ و جستجو ساده شود. نمونه ساختار پیشنهادی:
{
  "timestamp": "2026-10-26T12:34:56Z",
  "runId": "123e4567-e89b-12d3-a456-426614174000",
  "nodeId": "process-node-1",
  "eventType": "error",
  "httpStatus": 500,
  "message": "TypeError: Cannot read property 'id' of undefined",
  "payloadSummary": { "keys": ["userId","orderId"], "size": 512 }
}
6. نقاط لاگ میانی و حریم خصوصی
در گرههای حساس، قبل و بعد از تبدیل لاگ ثبت کنید. اما نکته حیاتی: دادههای حساس را ماسک یا هش کنید تا قوانین حفظ حریم خصوصی رعایت شود. برای نمونه، بهجای ذخیره کامل شماره کارت، از خلاصه یا شناسه غیرقابل بازگشت استفاده کنید.
الگوهای رایج برای Retry و مدیریت نرخ
هنگام برخورد با سرویسهای خارجی، الگوهای زیر مفید هستند:
- بکآف نمایی با حداکثر سقف: افزایش فاصله بین تلاشها بهصورت تصاعدی تا سقف مشخص، سپس توقف یا انتقال به صف پردازشی،
- جریان شتابگیر محدود (circuit breaker): در صورت تکرار خطاهای یک سرویس، تماسها را برای مدتی مسدود کنید تا سیستم هدف ریکاور کند،
- صفبندی با اولویت: اگر ورودیها زیاد هستند، آنها را صف کنید و بر اساس اولویت یا SLA پردازش کنید.
برای مثال پیادهسازی بکآف نمایی میتواند از الگوی زیر پیروی کند: تا N تلاش؛ فاصله = min(baseDelay * 2^attempt, maxDelay).
نمونه جدول بررسی سریع
| مسئله محتمل | نشانهها | اقدامات پیشنهادی |
|---|---|---|
| ورودی نامعتبر | خطاهای پارسینگ، رفتار غیرمنتظره | اعتبارسنجی، نمونهسازی مرزی، افزودن گاردهای شرطی |
| قطع اتصال به سرویس خارجی | تایماوت، کدهای 5xx یا 429 | آزمون اتصال، بررسی احراز هویت، Retry با بکآف |
| خطای منطقی در گره | خروجی نادرست یا ناسازگار | تستهای واحد، بازبینی منطق و لاگ میانی |
| فشار منابع | افزایش زمان پاسخ، OOM، کندی | کاهش اندازه دستهها، محدودسازی حافظه، مانیتورینگ |
مثال عملی: تشخیص و رفع خطای یک گردشکار سهمرحلهای
فرض کنید گردشکار شامل دریافت داده، پردازش و ارسال است و مرحله پردازش با خطا مواجه میشود. روند پیشنهادی:
- ثبت پیام خطا، شناسه اجرا و پارامترهای ورودی،
- اجرای گره دریافت داده با همان ورودی برای تایید سالم بودن دادهها،
- اجرای گره پردازش جداگانه با ورودی کنترلشده و افزودن لاگ میانی،
- مقایسه لاگهای موفق و ناموفق برای یافتن تفاوت در payload یا محیط اجرایی،
- اگر خطا از سرویس خارجی است، محدودیت نرخ و سیاست Retry را بررسی کنید،
- پس از اصلاح، اجرای یک سناریوی انتها-به-انتها در محیط تست و سپس staging.
این روش روندی سیستماتیک برای خطایابی ورکفلو n8n فراهم میآورد که قابل تکرار و مستندسازی است.
نکات پیشرفته و رفتارهای پیشنهادی
- تفکیک وظایف بزرگ به گرههای کوچکتر برای افزایش قابلیت تست و کاهش سطح خطا،
- فراهم کردن متادیتا برای هر اجرا (مانند نسخه ورکفلو، commit id) تا علتهای مرتبط با انتشار آسانتر شناسایی شود،
- ذخیره نمونه لاگهای موفق و ناموفق همراه با metadata برای تحلیلهای آینده،
- تعریف آلارمهای معنادار بر اساس نرخ خطا یا زمان پاسخ، نه فقط تعداد خطاها.
روشهای سریع برای کاهش زمان تشخیص
چند اقدام عملی که فوراً زمان تشخیص را کاهش میدهد:
- افزودن شناسه اجرا به تمام لاگها و اعلانها،
- استفاده از نمونهبرداری برای لاگهای پرحجم و ذخیره نمونههای کامل در زمان خطا،
- تعریف تستهای اتوماتیک انتها-به-انتها که پس از هر تغییر اجرا شوند،
- مستندسازی چکلیستهای بازیابی برای سناریوهای متداول.
پرسشهای متداول (FAQ)
1. چگونه سریعاً تشخیص دهیم مشکل از ورودی است یا گرهای خاص؟
گرهها را جداگانه اجرا کنید و لاگ میانی اضافه کنید. اگر گره با ورودی کنترلشده بدون خطا اجرا شود، احتمالاً مشکل از ورودی یا دادههای زمان اجرا است.
2. آیا همیشه باید لاگ کامل ذخیره شود؟
خیر؛ لاگ کامل هزینه و ریسک نشت اطلاعات دارد. از نمونهبرداری و سطوح لاگ استفاده کنید و دادههای حساس را ماسک نمایید.
3. وقتی خطا مربوط به سرویس خارجی است چه اقداماتی لازم است؟
ابتدا وضعیت سرویس را تایید کنید، سپس سیاستهای retry با بکآف، کش محلی یا صفبندی را لحاظ کنید. بررسی محدودیت نرخ و احراز هویت نیز ضروری است.
4. چه معیارهایی برای تصمیم به rollback مناسب است؟
اگر خطا موجب اختلال کاربران یا خطر نقض داده میشود، rollback سریع همراه با بررسی علت مناسب است؛ در غیر اینصورت، اصلاحات کوجک و کنترلشده منتشر کنید.