
معماری نرمافزار هوش مصنوعی: راهنمای عملی برای طراحی و پیادهسازی
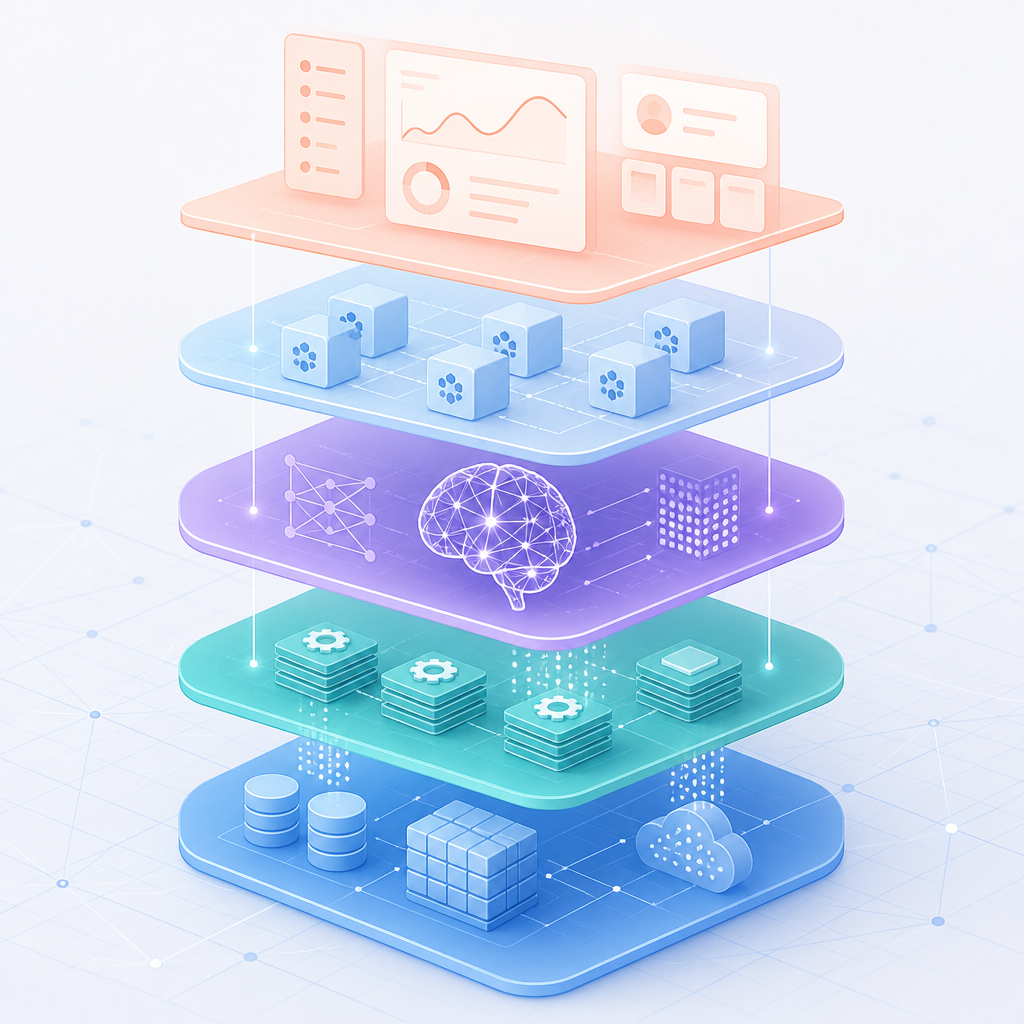
معماری نرمافزار هوش مصنوعی: راهنمای عملی برای طراحی و پیادهسازی
معماری نرمافزار هوش مصنوعی به مجموعهای از تصمیمها و الگوهای ساختاری گفته میشود که رفتار، قابلیت نگهداری و توسعهپذیری سامانههای مبتنی بر مدلهای یادگیری را شکل میدهد. این نوشته با تمرکز روی جنبههای عملی، معیارهای فنی و گامهای اجرایی، برای توسعهدهندگان، معماران نرمافزار و مدیران فنی تهیه شده است تا بتوانند سامانههایی قابل اطمینان، قابل مقیاس و قابل نگهداری بسازند.
اصول طراحی در معماری نرمافزار هوش مصنوعی
در طراحی هر سامانهٔ مبتنی بر هوش مصنوعی باید چند اصل بنیادین رعایت شود تا توسعه، استقرار و نگهداری مدلها در طول زمان امکانپذیر و کمهزینه باشد: جداسازی نگرانیها، قابلیت مقیاسپذیری، مدیریت داده و نسخهبندی مدلها. هدف، فراهم کردن مسیرهای تست، استقرار و بازگردانی سریع بدون ایجاد اختلال در سرویسهای تولیدی است.
جداسازی نگرانیها و لایهبندی
تفکیک مسئولیتها بین لایههای داده، پردازش، مدل و نمایش باعث میشود تغییر در یک لایه کمترین اثر جانبی را بر سایر بخشها داشته باشد. در عمل این جداسازی شامل سرویسهای گردآوری داده، پایپلاینهای پردازش، مخازن مدل و APIهای سرویسدهی است. پیشنهاد عملی: قراردادهای API و فرمتهای ورودی/خروجی را از روز اول مشخص کنید تا وابستگی بین تیمها کاهش یابد.
قابلیت مشاهده و مانیتورینگ
معماری باید مکانیزمهایی برای مشاهدهٔ سلامت مدل و داده فراهم کند: لاگینگ ساختاریافته، متریکهای زمان اجرا، و ابزارهای تحلیل توزیع ورودی و خروجی. بدون دادههای مشاهدهپذیر، تشخیص انحراف مدل (drift) یا افت عملکرد دشوار خواهد بود. پیشنهاد عملی: حداقل شاخصهای latency، throughput، خطا، دقت تخمینی و توزیع ویژگیها را ثبت کنید.
قابلیت مقیاسپذیری و تحمل خطا
معماری باید از مقیاس افقی و عمودی پشتیبانی کند و در طراحی سطوح مختلف تأخیر (latency) و حجم بار تصمیمگیری شود. استفاده از صفها برای قطعکردن اتصال مستقیم بین مصرفکننده و پردازشگر، و مکانیزمهای کش برای کاهش بار استنتاج، از الگوهای معمول هستند.
معماری نرمافزار هوش مصنوعی
یک معماری عملیاتی شامل چند جزء کلیدی است که هرکدام نقش مشخصی در چرخهٔ تولید مدل و خدمتدهی ایفا میکنند. در ادامه اجزاء اصلی همراه با وظایف و نمونه پیادهسازیهای عمومی آمده است.
| جزء | وظیفه اصلی | نمونهٔ پیادهسازی (بدون ذکر نام تجاری) |
|---|---|---|
| منبع داده | گردآوری و ذخیره دادههای خام | پایگاههای زمانی، مخازن ابری، صفهای رویداد و منابع لاگ |
| پایپلاین پردازش | پاکسازی، تبدیل و آمادهسازی داده | پردازش دستهای و جریانی، استخراج ویژگی، تبدیلهای ETL |
| مخزن مدل | ذخیره، نسخهبندی و ثبت متادیتا | ذخیرهسازی نسخهای با متادیتای آزمایش و پارامترها |
| سرویس استنتاج | اجرای مدل و ارائه پیشبینی به مصرفکننده | APIهای REST یا gRPC با مکانیزم cache و batch |
| مانیتورینگ و نگهداری | ردیابی عملکرد، هشدار و واکنش به افت | داشبورد شاخصها، سیستم هشدار و فرآیند بازآموزی |
نکات عملی برای هر جزء
- منبع داده: استانداردهای ورودی را تعریف و نمونهسازی کنید؛ پاکسازی اولیه باید نزدیک به منبع انجام شود.
- پایپلاین پردازش: جدا کردن مسیرهای batch و streaming و داشتن پایپلاینهای تست برای هر تغییر ضروری است.
- مخزن مدل: همراه با مدل حتماً متادیتا، معیارهای آزمایش و دادههای نمونه نسخهبندی شود.
- سرویس استنتاج: قرارداد SLA و بودجهٔ تاخیر را مشخص و تست بار را به صورت دورهای اجرا کنید.
الگوهای معماری متداول و انتخاب بین آنها
الگوهایی که در پروژههای مختلف مشاهده میشوند شامل معماریهای مبتنی بر میکروسرویس، معماری دادهمحور و الگوهای جریان داده هستند. انتخاب الگو بسته به نیازهای عملکردی، حجم داده و فرکانس پاسخدهی انجام میشود. در ادامه مقایسهٔ عملی سه الگوی رایج و موارد مناسب برای هر یک آمده است.
الگوی batch
مناسب برای پردازش دورهای، آموزش مجدد مدلها و گزارشهای تحلیلی. مزایا: سادگی عملیات، هزینهٔ کمتر برای پردازشهای دستهای بزرگ. معایب: تأخیر بالا برای نتایج و نامناسب برای نیازهای بلادرنگ.
الگوی streaming
برای پاسخهای بلادرنگ و تحلیل دادههای جاری مناسب است. مزایا: زمان پاسخ کوتاه و امکان واکنش سریع به تغییرات. معایب: پیچیدگی پیادهسازی، نیاز به ابزارهای پایدار برای پردازش پیوسته.
الگوی hybrid
ترکیبی از پردازش دستهای و جریانی برای تعادل بین دقت و تأخیر؛ دادهٔ تاملشده در batch برای آموزشهای عمیق و جریان برای پیشبینیهای فوری استفاده میشود. مناسب برای محصولات با نیاز به همزمانی تصمیمگیری و تحلیل بلندمدت.
راهنمای تصمیمگیری
- اگر نیاز به پاسخ بلادرنگ دارید و بار تراکنشی بالا است، سمت streaming را انتخاب کنید.
- اگر تحلیلهای پیچیده تاریخی و بهصرفهسازی هزینه ملاک است، batch مناسبتر است.
- اگر هر دو نیاز وجود دارد، hybrid با تقسیم مسئولیتها بهترین گزینه است.
پایپلاین داده و چرخهٔ زندگی مدل
پایپلاین داده از گردآوری تا ذخیرهسازی و سپس آمادهسازی برای آموزش و استنتاج ادامه مییابد. چرخهٔ مدل شامل مراحل آزمایش، استقرار، مانیتورینگ، بهروزرسانی و بازنشانی است. مدیریت این چرخه با نسخهبندی، ردیابی آزمایشها و ثبت معیارها، ریسک خطا و بازگشت را کاهش میدهد.
مراحل عملی پایپلاین
- گردآوری: تعریف فرمت داده، تعیین فیلدهای الزامی و مکانیزم جمعآوری ثبتشده.
- ذخیرهسازی اولیه: نگهداری دادهٔ خام با نگهداری متادیتا و نقاط بازیابی زمانی.
- پردازش و استخراج ویژگی: تعریف توابع تبدیل و نگهداری نسخهٔ کد تبدیلها برای بازتولید کامل.
- آموزش و اعتبارسنجی: اجرای آزمایشات با ثبت پارامترها، seedها، و معیارها.
- استقرار: انتشار مدل با استراتژیهای آزمون مانند کاناری، مرحلهای یا آبی-نارنجی.
- مانیتورینگ و بازآموزی: رصد معیارها و ایجاد گردشکار بازآموزی خودکار یا نیمهخودکار.
الزامات نسخهبندی
نسخهبندی باید شامل شماره نسخه مدل، شناسه دادهٔ آموزشی، پارامترهای آموزشی و تاریخچهٔ آزمایش باشد. روش پیشنهادی: استفاده از شناسهٔ یکتا مبتنی بر هش برای هر ترکیب مدل-داده و نگهداری یک فایل متادیتای قابل خواندن انسانی.
مثال عملی: طراحی یک سرویس پیشنهاد محتوا
در این مثال عملی قدمبهقدم، اجزای ضروری و تصمیمهای معماری برای یک سرویس پیشنهاد محتوا که نیاز به پاسخ کمتاخیر دارد شرح داده شده است.
نیازمندیهای کلیدی
- زمان پاسخ زیر ۲۰۰ میلیثانیه برای بیشتر درخواستها.
- توانایی پردازش همزمان میلیونها رویداد کاربر در روز.
- سیستم بازآموزی که بتواند هر شب دیتا را تجمیع و مدل جدید تولید کند.
طراحی پیشنهادی
- لایهٔ جمعآوری رویداد: رویدادهای رفتار کاربر به صف رویداد فرستاده میشوند تا از افتارساز front-end جدا شوند.
- پایپلاین ویژگی: استخراج ویژگیهای کوتاهمدت در مسیر جریانی و ویژگیهای بلندمدت در batch انجام شود؛ نتیجهها در یک پایگاه ویژگی قابل خواندن برای استنتاج ذخیره شود.
- آموزش و آزمون A/B: مدلها به صورت دورهای آموزش داده شده و با آزمایشهای کنترل شده نسخهٔ برتر انتخاب میشود.
- استنتاج با تاخیر کم: مدلهای بهینهشده برای استنتاج در یک سرویس جدا با کش و مکانیزم batching برای درخواستهای مشابه اجرا شوند.
- fallback: در صورت خطا یا کاهش خدمات مدل، یک لایهٔ سادهٔ قانونمحور به عنوان پشتیبان پاسخ میدهد.
- مانیتورینگ: ثبت توزیع پیشبینیها، نرخ کلیک، نرخ خطا و تاخیر؛ تعریف شاخصهای درایور برای بازآموزی خودکار.
ملاحظات عملیاتی
بودجهٔ هزینه، محدودیتهای حریم خصوصی و سیاستهای نگهداری داده باید از ابتدا تعریف شوند. همچنین برنامهٔ پاسخ به حادثه (incident response) و امکان rollback فوری برای نسخهٔ مدل باید پیادهسازی شود.
امنیت، حاکمیت و ملاحظات اخلاقی
معماری باید حریم خصوصی، کنترل دسترسی و محافظت در برابر تهدیدات مرتبط با مدل را بهصورت پیشفرض لحاظ کند. در عمل به این معنی است که دادهها باید رمزنگاریشده ذخیره یا منتقل شوند، دسترسیها مبتنی بر نقش و نیاز صادر شود و عملیات مدل تحت ممیزی قرار گیرد.
اقدامات فنی پیشنهادی
- رمزنگاری داده در حالت استراحت و در حالت انتقال.
- احراز هویت و مجوزدهی مبتنی بر حداقل دسترسی.
- مکانیزمهای محافظت در برابر حملات استنتاج و تزریق داده: محدودیت نرخ، بررسی ورودی و نظارت بر الگوهای غیرمعمول.
- حفظ حریم خصوصی: کاهش مجموعهٔ دادهها، آنونیمسازی و نگهداری دورهای حذف دادهها.
رویکردهای اخلاقی
شفافیت در طراحی و گزارش عملکرد مدل، ارزیابی تبعیض بالقوه و امکان اعتراض کاربران به تصمیمهای خودکار باید در فرآیند طراحی لحاظ شود.
مانیتورینگ، معیارها و هشدارها
تعریف شاخصهای مناسب و سازوکار واکنش به آنها یکی از ارکان پایدارسازی معماری است. فهرست معیارهای کلیدی و اقدام پیشنهادی:
- Latency: تعیین SLA و هشدار در صورت عبور از آستانه.
- Throughput: مانیتور کردن درخواستها در واحد زمان برای مدیریت ظرفیت.
- Error rate: ثبت خطاهای سرویس و فعالسازی کانالهای هشدار خودکار.
- Data drift و concept drift: مقایسه توزیع ویژگیها و خروجیها با مرجع آموزشی؛ در صورت انحراف، آغاز فرایند بازآموزی یا بررسی کیفیت داده.
- Calibration و confidence: بررسی همترازی اعتماد مدل با نرخ خطا؛ در صورت افت، محدودیت در استفادهٔ مدل یا fallback پیشنهاد میشود.
برای هر معیار باید یک playbook واکنش تعریف شود: چه کسی در چرخه مسئول است، چه گامهایی باید برداشته شود و آیا بازگشت به نسخهٔ قبلی لازم است.
چکلیست عملی برای پیادهسازی
فهرستی از مواردی که در طراحی و پیادهسازی باید بررسی شوند:
- نسخهبندی داده و مدل: آیا هر اجرای آموزشی دارای شناسهٔ منحصربهفرد و متادیتا است؟
- تفکیک محیطها: آیا محیطهای توسعه، تست و تولید کاملاً جدا هستند؟
- تست و اعتبارسنجی: آیا تستهای انتها به انتها، تستهای عملکرد و تستهای رگرسیون تعریف شدهاند؟
- مانیتورینگ و thresholdها: آیا آستانههای هشدار و playbook واکنش وجود دارد؟
- نحوهٔ بازیابی: آیا فرایند rollback و کاناری برای انتشار مدلها مشخص است؟
- حریم خصوصی و دسترسی: آیا سیاستهای حذف داده، حداقلسازی و کنترل دسترسی پیاده شدهاند؟
سؤالات پرتکرار (FAQ)
چگونه معماری را برای مقیاسپذیری طراحی کنیم؟
سیستم را به سرویسهای مستقل تقسیم کنید، از صفها و کش استفاده کنید و پایپلاینهایی طراحی کنید که قابلیت افقی شدن داشته باشند. تراز هزینه و نیاز به تأخیر را بررسی و روی سناریوهای بار پیک تست انجام دهید.
چه زمانی مدل باید بازآموزی شود؟
بازآموزی بر اساس معیارهای مانیتورینگ مانند افت دقت، تغییر در توزیع ویژگیها یا ورود دادههای جدید با الگوهای متفاوت انجام میشود. بازآموزی میتواند زمانبندیشده یا رویدادی (وقوع drift) باشد.
چه راهکارهایی برای جلوگیری از خطا در تولید وجود دارد؟
تستهای انتها به انتها، بررسی ورودیها، سنجش confidence خروجی، استراتژیهای fallback و انتشار مرحلهای مدل (کاناری) از راهکارهای متداول هستند.