
پایتون پردازش تصویر بینایی ماشین: راهنمای جامع برای شروع
پایتون پردازش تصویر بینایی ماشین: راهنمای جامع برای شروع
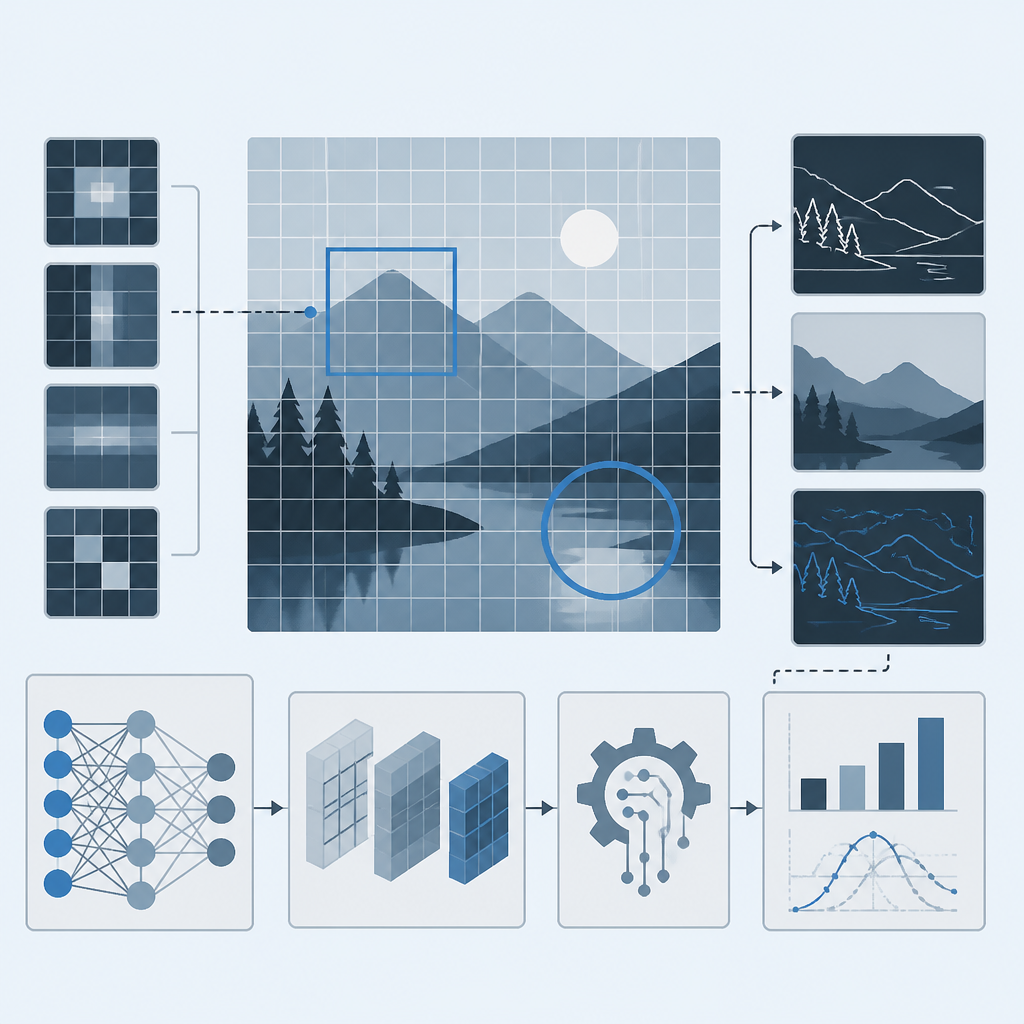
پایتون پردازش تصویر بینایی ماشین حوزهای عملی و میانرشتهای است که ابزارهای محاسباتی، پردازش سیگنال و یادگیری را برای استخراج اطلاعات از تصاویر و ویدئوها ترکیب میکند. این راهنما مسیر گامبهگام، تصمیمسازی فنی و مثالهای کاربردی را ارائه میدهد تا پروژههای واقعی با سهولت و کیفیت توسعه یابند.
مقدمه و اهمیت
تصاویر و ویدئوها منابعی سرشار از اطلاعات هستند. پایتون پردازش تصویر بینایی ماشین این امکان را فراهم میکند که دادهٔ بصری خام به نمایههای عددی، برچسبها و تصمیمات قابل اتکا تبدیل شود. کاربردها شامل تشخیص و طبقهبندی اشیاء، ردیابی، بررسی کیفیت تولید، تحلیل رفتار و بازسازی سهبعدی است. هدف این متن ارائهٔ یک مسیر عملی، از طراحی داده تا استقرار، همراه با نکات اجرایی برای افزایش قابلیت اعتماد و کارایی است.
پایتون پردازش تصویر بینایی ماشین: اصول و جریان کاری
هر پروژهٔ پردازش تصویر اغلب شامل مراحل مشخصی است که تکرارپذیری، تقسیم کار و ارزیابی کیفیت را تسهیل میکند. ساختار پیشنهادی زیر برای مدیریت پروژهها مناسب است:
- تعریف مسئله و معیار موفقیت: تعیین دقیق خروجی مورد انتظار، معیارهای ارزیابی و شرایط عملکرد در محیط واقعی.
- جمعآوری و فرمتدهی دادهها: تعیین فرمت فایل، ساختار پوشه، متادیتا (زمان، زاویه، شرایط روشنایی) و استاندارد برچسبگذاری.
- پاکسازی و پیشپردازش: تبدیل رنگ، تغییر اندازه، همسانسازی نور، حذف نویز و حذف فریمهای نامناسب.
- افزایش داده (augmentation): چرخش، برش، برابرسازی روشنایی و تبدیلات هندسی که بازتابدهندهٔ تغییرات محیطی واقعی باشد.
- انتخاب نمایش و مدل: استخراج ویژگیهای دستی یا طراحی ورودی برای مدلهای انتهابهانتها.
- آموزش، اعتبارسنجی و تنظیم هایپرپارامترها: تقسیم داده، ارزیابی معیارها و بهینهسازی عملکرد.
- بهینهسازی، استقرار و پایش: فشردهسازی مدل، تست سرعت استنتاج، مستندسازی نسخهها و مانیتورینگ در تولید.
نکات کلیدی در هر مرحله
- کیفیت برچسبها معمولاً اثر بیشتری نسبت به حجم خام داده دارد؛ نمونههای نادرست یا ناسازگار سریعاً عملکرد را کاهش میدهند.
- پیشپردازش ثابت (همسانسازی اندازه و بازهٔ پیکسل) باعث تکرارپذیری نتایج میشود و مقایسهپذیری آزمایشها را بالا میبرد.
- در افزایش داده، تغییرات باید واقعگرایانه باشند؛ اعمال تبدیلات غیرمعقول سبب کاهش دقت در میدان واقعی میشود.
قالبهای داده، نوعهای پیکسل و مدیریت حافظه
در پروژههای پردازش تصویر با آرایههای عددی سر و کار داریم. انتخاب عمق بیت، کانالها و فشردهسازی روی حافظه، دقت و زمان بارگذاری تأثیر مستقیم دارد. جدول مفهومی زیر را در نظر بگیرید:
- خاکستری (یک کانال): حجم کمتر و مناسب مسایل بافت و لبه.
- رنگی (سه کانال): حفظ اطلاعات رنگی برای تشخیص اشیاء و طبقهبندی رنگی.
- FP16/FP32: انتخاب دقت عددی بر اساس نیاز مدل و سختافزار؛ در برخی موارد FP16 کافی و سریعتر است.
پیشنهاد عملی: اگر حافظه محدود است، پیشپردازشها را پیش از بارگذاری روی دیسک انجام دهید و نسخهٔ فشرده و نسخهٔ با دقت کامل را حفظ کنید تا امکان بازتولید تجربیات وجود داشته باشد.
الگوریتمها و مقایسه روشها
در عمل، ترکیبی از روشهای کلاسیک و یادگیری انتخاب میشود. فاکتورهای کلیدی در انتخاب روش عبارتاند از: حجم دادهٔ برچسبخورده، زمان پاسخ مورد نیاز، پیچیدگی پیادهسازی و قابلیت توضیحپذیری.
تکنیکهای کلاسیک
- فیلترهای مکانی و فرکانسی: مناسب برای حذف نویز و آشکارسازی الگوهای پایه.
- تقسیمبندی مبتنی بر آستانه یا خوشهبندی: ساده و کمهزینه برای مسائل با کنتراست مناسب.
روشهای مبتنی بر یادگیری
- مدلهای با ویژگیهای استخراجشده دستی: کاربردی وقتی دادهٔ آموزشی محدود است.
- مدلهای انتهابهانتها: مناسب برای مسائل پیچیده با دادهٔ زیاد و نیاز به یادگیری نمایههای غنی.
چکلیست انتخاب روش: هزینهٔ محاسباتی، دسترسی به دادهٔ برچسبخورده، نیاز به زمان واقعی، قابلیت توضیحپذیری و پیچیدگی پیادهسازی.
مثال عملی گامبهگام (شبهکد کاربردی و تصمیمهای طراحی)
در ادامه یک جریان عملی با توضیحات فنی برای اجرای پروژههای کوچک تا متوسط آورده شده است. توابع بهصورت مفهومی نامگذاری شدهاند تا وابستگی به یک کتابخانهٔ خاص وجود نداشته باشد.
# گام 1: بارگذاری مجموعه داده و متادیتا
images, metadata = load_dataset('path/to/data')
# گام 2: بررسی کیفیت و فیلتر اولیه
images, metadata = filter_bad_frames(images, metadata, min_size=(50,50))
# گام 3: پیشپردازش پایدار
processed = []
for img in images:
img = resize(img, (256,256)) # ثابتسازی ابعاد
img = normalize(img, method='minmax') # همسانسازی دامنه پیکسل
img = denoise(img, method='gaussian', sigma=0.8)
processed.append(img)
# گام 4: افزایش داده بر اساس سناریو
augmented = augmentation_pipeline(processed, transforms=['flip','rotate_15','brightness_0.1'])
# گام 5: آمادهسازی ورودی مدل
features = [compute_descriptors(x, type='local') for x in augmented]
labels = load_labels('path/to/labels.csv')
# گام 6: تقسیم داده و آموزش اولیه
train, val = split_dataset(features, labels, ratio=0.8)
model = build_model(input_shape=train[0].shape, output_classes=num_classes)
model.train(train, epochs=25, batch_size=16, lr=0.001)
# گام 7: ارزیابی و تنظیم هایپرپارامتر
metrics = model.evaluate(val)
print(metrics)
# گام 8: ذخیره نسخهٔ نهایی و راهاندازی خط استنتاج
model.export('path/to/model_file')
create_inference_pipeline(model, preprocessor=normalize)
تنظیمهای مهم
- اندازهٔ بچ: بین حداکثر حافظهٔ قابل دسترس و پایداری گرادیان انتخاب شود.
- نرخ یادگیری: از روشهای کاهش پویا (scheduler) برای همگرایی بهتر استفاده کنید.
- ثبت تجربیات (logging): هر آزمایش را با پارامترها، نسخهٔ داده و معیارها ثبت کنید تا قابلیت بازتولید فراهم شود.
بهینهسازی، پروفایلینگ و استقرار
بهینهسازی در عمل شامل کاهش زمان استنتاج، مصرف حافظه و تضمین مقیاسپذیری است. گامهای عملی زیر به بهبود عملکرد کمک میکنند:
- پروفایلینگ کد برای شناسایی گلوگاهها در CPU/GPU و حافظه؛ سپس بهینهسازی بخشهای بحرانی.
- کاهش ابعاد ورودی یا استفاده از نمونهبرداری هوشمند برای کاهش بار محاسباتی.
- آزمایش سرعت استنتاج روی سختافزار هدف و اعمال فشردهسازی یا پروندهسازی مدل طبق نیاز.
- پایش عملکرد پس از استقرار و جمعآوری نمونههای خطادار برای بازآموزی دورهای.
مستندسازی مسیر استقرار (از نمونهسازی محلی تا تولید) و تعریف معیارهای هشدار برای افت عملکرد، از نکات کلیدی در حفظ کارایی سیستم است.
معیارها و ارزیابی
معیار مناسب تابعی از مسئلهٔ شماست. مثالهایی از معیارهای کلیدی:
- دقت کلی و ماتریس درهمریختگی برای مسائل طبقهبندی.
- IOU و F1 برای مسائل تقسیمبندی ناحیهای.
- میانگین زمان استنتاج و مصرف حافظه برای سنجش قابلیت اجرا در زمان واقعی.
همچنین جداسازی دادههای آزمایشی بر اساس شرایط محیطی (روشنایی، زاویه، نوع دوربین) کمک میکند تا نقاط ضعف مدل شناسایی و بهطور هدفمند بازآموزی انجام شود.
چکلیست برچسبگذاری و کیفیت داده
- تعریف دقیق دستورالعمل برچسبگذاری برای کاهش ابهام.
- بازبینی نمونهای از برچسبها توسط بازبینیکنندهٔ مستقل برای تخمین نرخ خطا.
- حفظ نمونهٔ نماینده از شرایط نادر برای تضمین عمومیت مدل.
منابع و مطالعهٔ بیشتر
برای مروری بر مفاهیم پایهٔ پردازش دیجیتال تصویر میتوانید مرجع عمومی زیر را ببینید:
Digital image processing — Wikipedia
همچنین مرور مقالات پژوهشی و گزارشهای فنی مرتبط با سناریوی کاری شما به انتخاب روش مناسب کمک خواهد کرد.
سوالات متداول (FAQ)
- آیا برای شروع نیاز به دانش ریاضی دارم؟
- یادگیری جبر خطی، آمار پایه و مفاهیم بهینهسازی کمک میکند اما پروژهٔ عملی همراه با یادگیری موازی نیز موثر است.
- چه مقدار داده نیاز دارم؟
- وابسته به پیچیدگی مسئله است؛ مسائل ساده با چند صد نمونه قابل آغازند اما مسائل پیچیده معمولاً نیاز به هزاران نمونه برچسبخورده دارند.
- آیا همیشه باید از مدلهای بزرگ استفاده کنم؟
- خیر. در بسیاری از موارد مدلهای سبک یا روشهای کلاسیک با تنظیم دقیق و دادهٔ مناسب عملکرد قابل قبولی دارند و هزینهٔ کمتری دارند.
- چگونه عملکرد در میدان واقعی را بسنجیم؟
- نمونههای واقعی جداگانه جمعآوری و با معیارهای تعریفشده ارزیابی کنید؛ پس از استقرار نیز پایش زنده و جمعآوری نمونههای خطادار برای بازآموزی مهم است.
جمعبندی
پایتون پردازش تصویر بینایی ماشین ترکیبی از دانش فنی و تصمیمسازی مهندسی است. با پیروی از جریان کاری منظم—تعریف مسئله، جمعآوری و آمادهسازی داده، انتخاب نمایش و مدل مناسب، آموزش و ارزیابی، و در نهایت بهینهسازی و استقرار—میتوان سامانههای کاربردی و قابل اعتماد ساخت. توجه ویژه به کیفیت برچسبها، ثبت کامل آزمایشها و پروفایلینگ عملکرد، مسیر موفقیت در پیادهسازیهای واقعی را کوتاهتر میکند.