
پایگاهدادههای هوشمند اپلیکیشنها؛ طراحی، استراتژی و پیادهسازی عملی
پایگاهدادههای هوشمند اپلیکیشنها؛ طراحی، استراتژی و پیادهسازی عملی
در این مقاله جامع مفاهیم پایه حفظ شده و با افزودن راهکارهای عملی، مثالهای واقعی و چکلیستهای فنی تکمیل شده است. هدف کمک به تیمهای توسعه و عملیات در طراحی و استقرار پایگاهدادههای هوشمند اپلیکیشنها با تمرکز بر عملکرد، مقیاسپذیری و قابلیت نگهداری است.
چرا پایگاهدادههای هوشمند اپلیکیشنها اهمیت دارند؟
افزایش حجم دادهها و تغییرپذیری الگوهای دسترسی به داده باعث شده است راهکارهای سنتی دیگر به تنهایی پاسخگو نباشند. سیستمهای هوشمند با توانایی تحلیل الگوهای دسترسی در زمان اجرا، مدیریت خودکار ایندکسها و انتخاب مدل داده مناسب، میتوانند رضایت کاربر را بالا برده و هزینههای عملیاتی را کاهش دهند. این سیستمها معمولاً ترکیبی از لایههای ذخیرهسازی، کش، پردازش رویداد و مشاهدهپذیری را بهکار میگیرند تا بین عملکرد و هزینه توازن برقرار شود.
تعاریف و مفاهیم کلیدی
هوشمندی در سطح داده
هوشمندی به معنی فراتر رفتن از عملیات CRUD است: شامل تحلیل بلادرنگ الگوهای دسترسی، تنظیم خودکار پارامترها (مانند اندازه صفحات و پارامترهای ایندکس)، بازآرایی ایندکسها بر مبنای بار و تطبیق مدل داده با الگوی مصرف. در عمل این قابلیتها مداخله دستی را کاهش میدهند و پاسخ سامانه را به تغییرات بار سریعتر میکنند.
الگوهای دادهای و مدلهای ترکیبی
ادغام مدلهای رابطهای، اسناد و گراف در یک پلتفرم یا در پشتهای هماهنگ، انعطافپذیری را افزایش میدهد. بهطور معمول دادههای تراکنشی در مدل رابطهای، دادههای نیمهساختاریافته در مدل اسنادی و روابط پیچیده در مدل گراف ذخیره میشوند. تصمیمگیری برای نگهداری در هر مدل باید بر مبنای نسبت خواندن/نوشتن، نیاز تحلیلی و تاخیر قابل قبول انجام گیرد.
معماری پیشنهادی و اجزای کلیدی
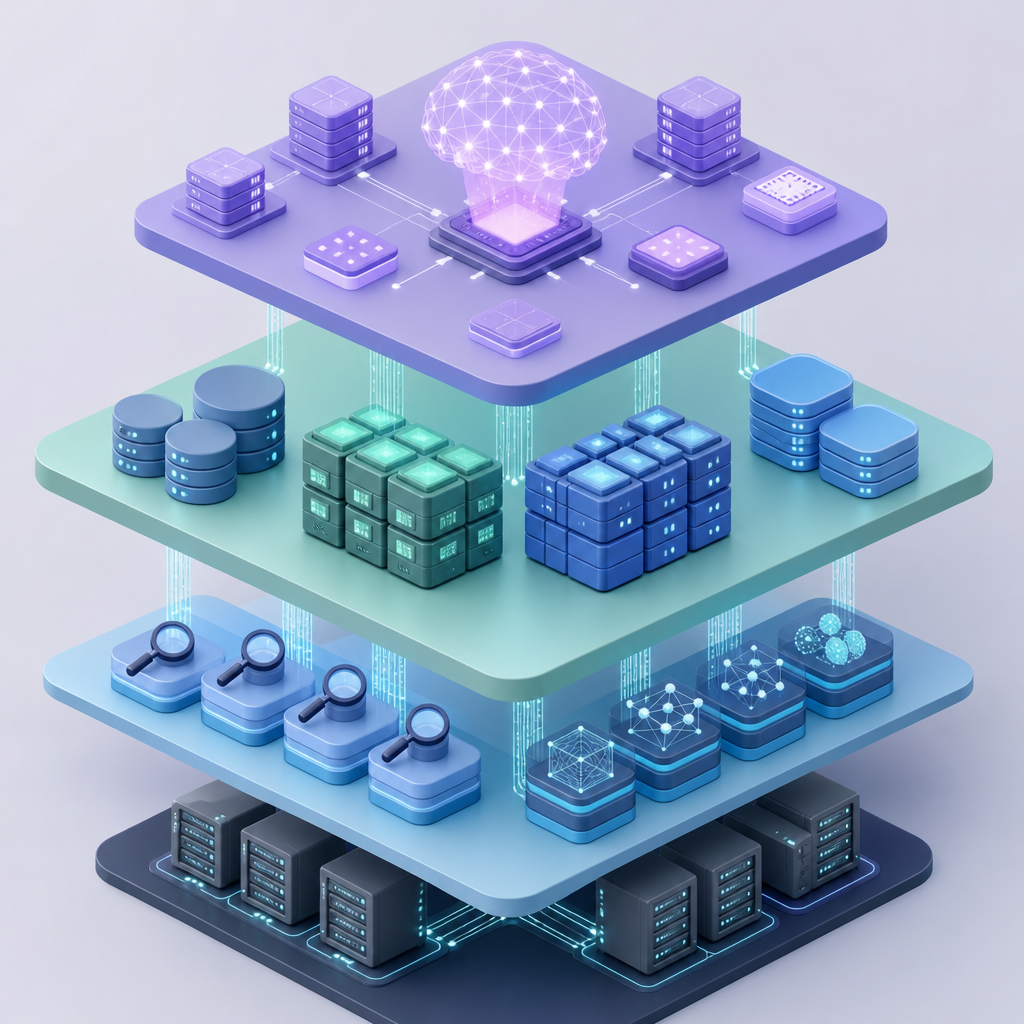
یک معماری عملیاتی برای پایگاهدادههای هوشمند باید مقیاسپذیری، تحمل خطا، عملکرد و قابلیت نگهداری را تضمین کند. اجزا و نقش هرکدام:
- لایه ذخیرهسازی چندوجهی برای تفکیک دادههای تراکنشی، تحلیلی و آرشیوی و بهینهسازی هزینه.
- کش هوشمند با سیاستهای قابل پیکربندی (LRU/LFU/TTL ترکیبی) و امکان کش لایهای (edge، اپلیکیشن، دیتابیس).
- صفهای رویداد برای جداسازی نوشتن و پردازش غیرهمزمان و تضمین قابلیت بازپخش پیامها.
- واسطهای پرسوجوی تطبیقی که پرسوجوها را بسته به نوع داده و بار به بهترین منبع هدایت کنند.
- سامانه مشاهدهپذیری برای جمعآوری متریکها، لاگها و تریسها و بازخورد به مکانیزمهای خودتنظیمی.
نمونه شاخصهای کلیدی (SLI/SLO)
برای هر سرویس باید شاخصهای قابل اندازهگیری تعریف شوند؛ مثال عملی:
- SLI تاخیر خواندن: 95٪ پاسخها زیر 75 میلیثانیه.
- SLI تاخیر نوشتن: 99٪ تراکنشها زیر 200 میلیثانیه.
- SLO قابلیت دسترسی: 99.9٪ ماهانه.
- SLO بازیابی از خطا: RTO زیر 5 دقیقه برای سرویسهای بحرانی.
پایگاهدادههای هوشمند اپلیکیشنها
این بخش بهصورت گامبهگام به نحوه پیادهسازی و استقرار میپردازد. رویکرد پیشنهادی شامل تحلیل نیازمندیها، طراحی منطقی، پیادهسازی افزایشی و پایش مستمر است.
گامهای عملی برای پیادهسازی
- تعریف اهداف کسبوکار: تاخیر هدف، توان عملیاتی موردنیاز، و نیازهای گزارشدهی.
- جمعآوری و تحلیل الگوهای دسترسی اولیه: نمونهگیری از ترافیک واقعی برای تحلیل نسبت خواندن/نوشتن و الگوهای پرسوجو.
- طراحی نگاشت داده: کدام داده در لایه تراکنشی، کدام در لایه تحلیلی و چه مواردی نیاز به کپی یا نمایهسازی دارند.
- تعریف سیاستهای کش: تعیین TTLهای پیشفرض، آستانههای اجرا برای LFU/LRU و ترتیب لایهها.
- پیادهسازی جریان رویداد و تضمین تحمل خطا: استفاده از صفهای قابل بازپخش و idempotent بودن مصرفکنندهها.
- ایجاد داشبوردهای مشاهدهپذیری و چرخه بازخورد خودکار برای ایندکسگذاری و توزیع داده.
- آزمون بار، سناریوهای خطا و برنامه بازیابی بلایا قبل از تولید.
الگوها و تکنیکهای عملی
الگوهای عملی که رایج و اثربخشاند:
- CQRS برای تفکیک مسیرهای خواندن و نوشتن و بهبود مقیاسپذیری خواندن.
- Event Sourcing برای ثبت تغییرات بهصورت تسلسل وقایع و امکان بازپخش وضعیت.
- کش لایهای با سیاستهای ترکیبی و مکانیزم invalidation مبتنی بر رویداد.
- ایندکسگذاری هوشمند: مانیتور ترافیک پرسوجو و ایجاد ایندکسهای پویا بر اساس هزینههای واقعی پرسوجوها.
- شبیهسازی تاثیر تغییرات ایندکس یا پیکربندی ذخیرهسازی با نمونه داده قبل از اعمال در تولید.
مزایا و محدودیتها
هر تکنیک مزایا و مخاطراتی دارد؛ CQRS پیچیدگی همگامسازی را بالا میبرد، Event Sourcing نیازمند حجم ذخیرهسازی بیشتر و منطق بازپخش است و کشهای تهاجمی ممکن است منجر به ناسازگاریهای زمانی شوند. انتخاب باید بر اساس تحلیل هزینه-فایده و نیازهای کسبوکار انجام شود.
مثال عملی ۱ — سامانه ثبت سفارش سبک
هدف: کاهش تاخیر در ثبت سفارش و پشتیبانی از گزارشهای نزدیک به بلادرنگ.
- شناسایی دادهها: سفارش (تراکنشی)، خلاصه سفارش (تحلیلی)، لاگها (آرشیوی).
- نوشتن تراکنشی در یک دیتابیس ACID برای تضمین اتمیک بودن پرداخت و وضعیت سفارش.
- انتشار رویداد "order_created" به صف برای تولید خلاصههای تحلیلی بهصورت ناهمگام.
- کش هوشمند برای پروفایل کاربر و آیتمهای پرمصرف با TTL کوتاه و سازوکار invalidation هنگام تغییر داده.
- داشبورد مانیتورینگ برای اندازهگیری تاخیر نوشتن، زمان صف، و نرخ خطا و بازخورد به ایندکسگذاری.
جریان منطقی نمونه
// دریافت سفارش
validate(order)
beginTransaction()
writeTransactional(order)
publishEvent("order_created", orderSummary)
commit()
// مصرفکننده تحلیلی خلاصه را ذخیره میکند و شاخصها را بهروز میکند
توجه کنید مصرفکنندهها باید idempotent باشند تا بازپخش پیامها مشکلساز نشود.
مثال عملی ۲ — سرویس گزارشدهی تحلیلی بلندمدت
هدف: نگهداری تاریخچه کامل داده و اجرای پرسوجوهای پیچیده تحلیلی بدون تأثیرگذاری بر تراکنشها.
- رویدادها به صورت پیوسته به یک لایه تحلیلی ارسال میشوند و در نگاشت ستارهای (star schema) ذخیره میشوند.
- برای پرسوجوهای پیچیده از لایه جداسازیشده استفاده شده تا بار تحلیلی بر تراکنشها تاثیر نگذارد.
- نسخهبرداری و فشردهسازی تاریخچه داده برای کاهش هزینه ذخیرهسازی و تسهیل آرشیو.
نکات عملی در پیادهسازی و نگهداری
- تعریف متریکهای کلیدی: تاخیر خواندن/نوشتن، نرخ خطا، حجم صف، زمان بازپخش رویداد.
- پایش لاگ و تریس برای شناسایی گلوگاههای واقعی و نه حدسزدنی.
- آزمون بار و سناریوهای خطا شامل قطع نود، از دست رفتن شبکه و افزایش ناگهانی بار.
- برنامه پشتیبانگیری، مدیریت اسکیمای نسخهها و سناریوهای بازگشت (rollback) واضح.
- استقرار مرحلهای (canary/blue-green) و معیارهای قطع برای بازگرداندن تغییرات در صورت بروز مشکل.
برای استانداردها و الگوهای طراحی میتوانید به منابع رسمی وب مراجعه کنید: w3.org.
چکلیست تصمیمسازی و مهاجرت
- جمعآوری دادههای پایه: الگوهای دسترسی و پرسوجوها را حداقل برای دو هفته اندازهگیری کنید.
- طراحی نگاشت داده و شناسایی نقاطی که نیاز به کپیبرداری یا نمایهسازی دارد.
- تعیین SLO/SLI و معیارهای پذیرش برای فازهای آزمایشی.
- اجرای تستهای کارایی و بازیابی و ثبت نتایج برای تصمیمگیری درباره انتقال به تولید.
- برنامه استقرار مرحلهای و سناریوی بازگشت فوری (rollback) مشخص.
سؤالات متداول (FAQ)
- پایگاهدادههای هوشمند اپلیکیشنها چه تفاوتی با پایگاهدادههای سنتی دارند؟
- تفاوت اصلی در توانایی خودتنظیمی و پشتیبانی از تصمیمگیری مبتنی بر الگوهای دسترسی است؛ این سامانهها تلاش میکنند بدون مداخله دستی پارامترها، ایندکسها و توزیع داده را بهینه سازند.
- آیا همه اپلیکیشنها به چنین ساختاری نیاز دارند؟
- خیر. برای اپلیکیشنهای کوچک یا پایدار، پیچیدگی اضافی ممکن است توجیه نداشته باشد. تحلیل هزینه، پیچیدگی عملیاتی و منافع عملکردی باید سنجیده شوند.
- چطور از ناسازگاری کش جلوگیری کنیم؟
- استفاده از invalidation مبتنی بر رویداد، TTL مناسب و طراحی idempotent برای عملیات نوشتن راهکارهایی مؤثر است. در موارد حساس میتوان از کشهای خواندهشده-بعد-نوشتن اجتناب کرد یا آنها را با مکانیزم اعتبارسنجی ترکیب نمود.
- چه تستهایی قبل از استقرار لازم است؟
- آزمون بار، آزمون تحمل خطا، تست بازیابی بلایا، تست همگامسازی دادهها و تستهای عملکرد ایندکسها باید اجرا شود.
- چگونه ایندکسهای هوشمند را مدیریت کنیم؟
- با پایش هزینه پرسوجو (query cost)، ایجاد هشآستانه برای خودکارسازی ایندکسسازی و اجرای تغییرات ایندکس در محیط آزمایشی قبل از اعمال در تولید میتوانید ریسک را کاهش دهید.